Teaching Deck · Ontology Platform瀚好智慧科技 · hanhao.co
本体及其应用平台
从需求调研到 WorkBuddy Demo 演示
以 Palantir Foundry / AIP 为贯穿案例:把「业务世界的决策」建成可计算的对象、关系、动作与权限, 再在其上长出 AI 智能体,最后用一条可演示的闭环交付出去。
术语对照
| 术语 | 释义 |
|---|---|
| LLM | 大语言模型,会写会答的那个东西 |
| RAG | 检索增强生成:先找资料再让模型作答 |
| GraphRAG | 把文档先读成关系网再汇总作答 |
| QFS | 面向查询的摘要:按问题把长材料压成答案 |
| BM25 | 按词频、稀有度、文档长度算相关度的排序公式 |
| TF-IDF | 词频乘上「这个词有多不常见」 |
| KNN | 取最相近的前 k 条 |
| HNSW | 一种加速找最近的图状索引,用召回换速度 |
| HyDE | 先由模型生成假设答案,再用它检索 |
| RDF | 用「主语—谓语—宾语」三元组描述资源 |
| OWL | 写术语与公理、能做推理的本体语言 |
| SHACL | 给图数据做合规校验的约束语言 |
| SPARQL | 查三元组数据的查询语言 |
| MCP | 模型上下文协议:让智能体接外部工具的通用接口 |
| OAuth 2.0 | 开放授权:不交密码、给短期通行证的行业标准 |
| SSO | 单点登录:一次登录,多个系统通用 |
| API | 系统之间互相调用的接口 |
| 术语 | 释义 |
|---|---|
| SDK / OSDK | 开发工具包;OSDK 是面向本体的那一种 |
| ACID | 事务四性质:要么全成、要么全滚、互不干扰、落盘不丢 |
| ERP | 企业资源计划系统,管钱、货、单 |
| WMS | 仓库管理系统 |
| MES | 制造执行系统,管车间干活 |
| ETL | 抽取、清洗、装载,把数据搬进目标库 |
| CDC | 变更数据捕获:源系统一改就跟着同步 |
| SLA / SLO | 对外承诺的服务水平,和对内定的目标 |
| PoC | 概念验证:先验证可用,再讨论上线 |
| AIP | Palantir 的人工智能平台产品名,不是通用缩写 |
| OAG | 本体增强生成:把当前对象与动作作为模型回答的依据 |
| W3C | 万维网联盟,OWL/RDF 等标准的制定组织 |
| SQL | 结构化查询语言,关系数据库的查询语言 |
| VPC | 虚拟私有云,企业版的一种交付与网络隔离形态 |
| PK / FK | 主键 / 外键:对象身份与对象之间的引用 |
| SSE | 服务器发送事件,MCP 流式响应用的传输方式 |
这份稿子怎么读
本体平台的难点不在技术组件,而在「一条决策链路要同时穿过五个层」。 所以本稿按真实交付顺序展开,而不是按产品功能目录展开。
⓪ 坐标系 · ① 需求调研
先分清本体与全文检索 / LLM wiki / 知识图谱 / RAG / GraphRAG 的边界;再把要自动化的「决策」找出来,产出决策清单与范围边界。
② 本体构建
对象 / 关系 / 属性 / 接口 → 接入与索引 → 动作 → 逻辑 → 权限 → 检索。产出:可查可写的业务模型。
③ 智能体层
Agent Stack、检索上下文、工具契约、六层沙箱、评测与可观测、外部 Agent 接入。
④ Demo 演示
Onyx 四步回路逐图拆解,Titan 的 Data / Logic Tools 与过程挖掘实操,附三档现场脚本。
⑤ 落地两章
风险与自建(Top 10 常见问题、六面架构、路线图),以及把生产本体经 MCP 接到 WorkBuddy 与企业版上的完整 Demo。
用一句话定义本体:不是数据库,是业务世界的可计算模型
本体同时回答四个问题——世界由什么组成(对象与关系)、什么算数(属性与规则)、能改什么(动作)、谁能改(权限)。这四件事必须一次建好,缺一个都长不出应用。
| 维度 | 数据仓库 / 数据表 | 本体 / 业务对象 | 为什么这决定成败 |
|---|---|---|---|
| 基本单位 | 行、列、join | 对象、链接、动作 | 业务人员能直接读懂对象,读不懂 join |
| 写入 | 批量重跑、追加 | 受控动作(带回滚与审计) | 没有受控写入口,就只能看不能用 |
| 权限 | 表 / 视图粒度 | 行、列、单元格粒度 + 动作粒度 | AI 时代必须能「按人按动作」收紧 |
| 逻辑 | 散落在 SQL / ETL / 代码 | 与对象绑定的规则与函数 | 逻辑可被复用、被 LLM 当工具调用 |
| 消费者 | 分析师、报表 | 应用、自动化、智能体、外部系统 | 同一模型多种消费方式,不必各建一套 |
这四步回路就是 Palantir 讲「本体是决策的表示」时画的图(见第四部分 Onyx 五图)。
为什么现在必须做:RAG 的天花板与 OAG
RAG 让模型「读到片段」,但业务决策需要的是「知道此刻有哪些对象、处于什么状态、允许做什么动作」。 这正是本体增强生成(Ontology-Augmented Generation)要补的缺口。
纯 RAG 在业务里的四类失效
- 状态过期:文档写的是上季度库存,模型当成交付承诺。
- 无关系:能检索到订单,答不出「这单关联哪台设备、哪位负责人」。
- 无边界:检索与写操作没有权限模型,LLM 可能建议越权动作。
- 无留痕:给出答案却无法复现「当时看到什么、为什么这么做」。
OAG 提供什么
- 对象检索:语义 + 关键词混合检索,命中后是对象集,可继续操作。
- 关系遍历:从对象跳到相关对象(链接类型定义好了边界与方向)。
- 动作即工具:LLM 只能调用已定义动作,参数校验与权限自动生效。
- 引用与血缘:每条回答可指向具体对象/属性,决策可追溯。
| 阶段 | 模型看到的 | 能做的 | 典型产物 |
|---|---|---|---|
| 无增强 | 参数化记忆 | 猜 | 通用聊天 |
| RAG | 文档分片 | 引用文字 | 企业问答 |
| 工具型 RAG | 分片 + 若干 API | 调接口 | Copilot |
| OAG | 对象 / 对象集 / 动作 / 权限 | 检索→遍历→提交动作→留痕 | 能干活的智能体 |
本体不是知识库的另一种写法:六类体系横向对照
全文检索、LLM wiki、知识图谱、向量 RAG、GraphRAG、本体平台—— 它们的分歧不在「检索准不准」,而在能不能改世界。下表每格都取自该技术的官方文档或论文原文。
| 维度 | 全文检索 BM25 / 倒排 | LLM wiki DeepWiki / Rovo | 知识图谱 PG / RDF+OWL | 向量 RAG | GraphRAG 社区摘要 | 本体平台 对象+动作+权限 |
|---|---|---|---|---|---|---|
| 数据前提 | 文本字段 + analyzer | 已有 wiki / 代码库 | 显式建模,需人维护 | chunk + embedding 管线 | LLM 抽取实体与关系 | schema 是交付物:对象 / 属性 / 链接 / 动作 |
| 查询与推理 | 词法匹配 + 聚合 | 跨页问答,无形式推理 | 多跳遍历;OWL 可推理一致性 | 语义 top-k | 局部邻域 + 全局摘要 | 检索 + 多跳 + 聚合 + 函数 / 模型调用 |
| 数值与精确匹配 | 强 | 非确定性 | 取决于建模 | 弱:官方要求改用精确或混合 | 弱 | 强:类型与值类型校验 |
| 写入与执行 | 只读 | 只读 | 可写图库,不天然回写业务系统 | 只读 | 只读 | 原生动作层:事务写回 ERP / WMS / 工单 |
| 权限粒度 | 依赖外部 | 平台原生页面级 | 角色 + 子图 | 过滤发生在索引扫描之后 | 官方未说明 | 行 / 列 / 单元格,工具调用同受约束 |
| 新鲜度 | 增量索引 | 需重新索引仓库 | 取决于同步管线 | 需重新嵌入 | 需重跑 LLM 抽取 | 编辑即入索引,流式秒级检查点 |
| 维护成本 | 低 | 低到中 | 高:实体消解与漂移 | 中:chunk 与嵌入漂移 | 最高:官方文档警告昂贵 | 高:建模与治理 |
| 典型失效 | 同义词与意图不匹配 | 官方声明答案不可靠 | 图谱腐化、推理不可满足 | 召回衰减、租户互扰 | 社区层级选错即答偏 | 主键不确定、索引延迟、阈值 |
| 适用场景 | 精确词、编号、起步方案 | 看懂陌生库、团队问答 | 关联数据、可解释检索 | 自然语言问非结构化 | 全局归纳、主题 sensemaking | 实时决策 + 写回运营系统 |
全文检索:只认字面,但最便宜也最稳
像书末尾的索引表:先按词找到页码,再按「这个词在这页出现几次、这词在全部书里常不常见、这本书有多长」打分排序。 它比较的是词,不是含义。
它到底是什么
把所有文字切成词,建一张「哪个词出现在哪些文档」的对照表(倒排索引,inverted index)。 查询时查表、按公式打分(BM25,全称 Best Match 25,一种按词频算相关度的排序公式)。 官方对它的定义就一句:「快速、高效地搜索文档里的文本字段」。
企业出现这些信号就选它
- 员工搜的是编号:料号、合同号、工单号、错误码、人名。
- 查询里用的词,就是系统里存的那个词。
- 不想先养算法团队、不想买显卡。
- 要一个「先能用起来」的检索层,以后再升级。
怎么建:五步
- 圈定要搜的字段:标题、正文、编号、标签。
- 选一个搜索引擎,先不做花哨配置。
- 配分词与同义词表(中文必须有分词器,否则整句当一个词)。
- 接上数据源做增量同步,定好「多久能搜到新内容」。
- 拿 50 条真实提问测命中率;命中率不够再考虑加语义检索。
花多少钱
六类里最低。官方原话:它跑在普通处理器上,相比吃显卡的向量运算,需要的计算资源很少; 并且明确建议「可以先用全文检索起步,之后再逐步引入更复杂、更耗资源的方案」。
常见问题
- 换个说法就搜不到:「电脑」搜不到「笔记本」。
- 字面命中但意思错(同名不同物)。
- 同义词表没人维护,半年后命中率逐渐下降。
什么时候不够用
用户用大白话问、而库里是专业术语时;需要「按意思找」时——这时官方给的答案是混合检索 (hybrid search,把按词匹配和按意思匹配的结果合到一起),而不是把全文检索扔掉。
LLM wiki 助手:先让模型写手册,再在手册上问答
大语言模型(LLM,Large Language Model)先把一堆文档或代码读一遍,自动整理成一本人人能查的手册, 再基于这本手册回答问题。入门成本最低,也最容易被误当作事实来源。
它到底是什么
两层:先生成(自动产出架构图、目录、页面正文、指向原文的链接),再问答(提问时以这份生成物为上下文)。 代表形态是给代码仓自动出维基的工具,以及企业知识空间里内置的问答助手。
企业出现这些信号就选它
- 新人进来看不懂陌生系统,靠老人口头带。
- 文档很多很乱,但确实有人写。
- 需求只是「有个能问的东西」,不要求精确到数。
- 用户是开发者或内部员工,能容忍偶尔跑偏。
怎么建:五步
- 圈定输入:哪些仓库、哪个知识空间。
- 人工写目录清单:官方明说自动规划会漏掉重要部分,需要人为指定页面。
- 生成,注意页数与条数有硬上限。
- 人工校对关键页,把「不可靠」的段落改掉。
- 定期重新索引——默认只覆盖主分支,改动不重跑就是旧的。
花多少钱
低到中。基础档免费;更精细的产出按算力单位计费,成本随仓库规模上升; 企业组织通常被固定在基础档,配置项不可调。
常见问题
- 模型是概率性的,官方声明答案「可能不准确、不完整或不可靠」,「不应被依赖」。
- 官方建议:需要「当前准确的人和事」时不要用这类功能。
- 权限只继承到页面与空间级,不到字段级。
什么时候不够用
答案必须是「现在是多少」而不是「文档里写过什么」时;同一个事实需要在多处保持一致且会变时—— 这两条正是升级到知识图谱或本体的信号。
知识图谱:把「谁和谁有什么关系」画成一张网
适合回答「这个供应商出问题,会牵到哪些物料、哪些订单、哪些产线」这类关系型问题。 官方对它的定义是「存储、组织、访问相互关联实体的设计模式」。
它到底是什么
两条技术路线:属性图(节点 + 关系 + 属性,用图查询语言取数)与 资源描述框架(RDF,Resource Description Framework,用「主语—谓语—宾语」三元组描述资源)。 后者可再叠一层本体语言(OWL,Web Ontology Language)做推理,配一个约束语言 (SHACL,Shapes Constraint Language)做数据校验。
企业出现这些信号就选它
- 跨系统的实体关系本身就是核心资产。
- 要做影响分析、溯源、推荐关联。
- 要「可解释的检索」:能画出为什么把这两样连起来。
- 需要把多源同义实体对齐成一条。
怎么建:五步
- 先定少量实体类型与关系类型,宁缺勿滥。
- 定主键与对齐规则:同一个客户在三套系统里必须是一条。
- 装载数据,边装边做去重与冲突处理。
- 写查询:图查询语言或 RDF 查询语言(SPARQL,SPARQL Protocol and RDF Query Language)。
- 要推理才加约束层,并配校验规则。
花多少钱
高,而且贵在长期人力:模式治理与实体消解是持续工作,不是一次交付。 官方文档把图谱构建管线标为实验性,把「灵活模式、不必重建库」当卖点——两句话合起来读就是:加东西容易,管好难。
常见问题
- 图谱腐化:重复实体、失效关系越攒越多。
- 删除模式语句时性能可能很差。
- 默认不做一致性检测;推理规则集只覆盖标准的一部分。
- 为可判定性要放弃某些表达能力。
什么时候不够用
两件事一出现就该升级:① 图里的实体需要被改(状态、责任人、计划),而不只是被看; ② 需要按人隐藏某一行某一列——图库权限通常只到角色与子图,粒度不够。
向量 RAG:按「意思最近」找段落,喂给模型作答
检索增强生成(RAG,Retrieval-Augmented Generation):把文字变成一串数字(向量), 提问时找语义最接近的几段塞进上下文。它解决「能不能拿到外部知识」,不解决「世界知识怎么更新」。
它到底是什么
离线一条链:切块 → 用嵌入模型(把文本编码成向量的模型)编码 → 建向量索引。 在线一条链:问题编码 → 找最近邻(KNN,k-Nearest Neighbors,取最相近的前 k 条)→ 拼进提示词 → 生成。
企业出现这些信号就选它
- 非结构化资料多:手册、合同、工单、纪要。
- 员工用大白话问,词和库里不一样。
- 问的是「局部事实」:某条款怎么写的、这个报警怎么处理。
- 资料不能外传,需要私有部署。
怎么建:六步
- 先判断要不要建索引——资料能整份塞进上下文就别建,官方就是这么建议的。
- 切块:小块语义更独立,块太大答案变糊。
- 选嵌入模型,注意输入长度与维度上限。
- 建索引:近似索引换速度,也换召回。
- 加精确词检索兜底(混合检索)。
- 先测「该被搜到的有没有被搜到」,再测答案质量。
花多少钱
中。隐性成本在两处:近似索引要求向量全部驻留内存;量化能省内存但官方明说「以精度为代价」。 另外嵌入模型有维度硬上限,超了直接用不了。
常见问题
- 精确匹配做不到:搜索引擎官方把精确词匹配划给全文检索。
- 全局统计类问题「表现很差」:靠语义相似找不到方向。
- 过滤条件在索引扫描之后才应用——条件一严,结果条数骤减。
- 多租户共用一个索引时,互相拖累召回与速度。
什么时候不够用
问「现在有多少」「该做什么」时;数据本身活在业务系统里而不是文档里时。 平台方的原话值得引用:本体让智能体「超越以检索为中心的生成方案在数据层面的局限」。
GraphRAG:先让模型把文档读成网,再给每个圈子写小结
图检索增强生成(GraphRAG,Graph Retrieval-Augmented Generation)。 它存在的理由就是补向量 RAG 的洞:论文原话——「RAG 在面对针对整个语料库的全局性问题时会失败」。
它到底是什么
两段式:先用大模型从原文抽出实体与关系,形成图;再对「关系紧密的一群实体」(社区)预生成摘要报告。 提问时各份摘要先各自作答,再汇总成最终答案——本质是「面向查询的摘要」(QFS,Query-Focused Summarization)。
企业出现这些信号就选它
- 问题天生是归纳型:这批纪要最主要的三类痛点、这批合同的整体风险倾向。
- 要做 sensemaking(把散料读成一个判断),不是查单点事实。
- 语料量已经大到不可能整份塞进上下文。
怎么建:五步
- 切块(官方默认约 1200 词元,并说明块越大输出保真度越低)。
- 让模型抽实体、关系、以及带时效性的主张。
- 社区检测,划出「谁和谁是一伙的」。
- 预生成每个社区的摘要报告。
- 查询时选层级:层级低更细但更慢更贵。
花多少钱
六类里最高:索引是昂贵操作,会消耗大量模型资源,官方强烈建议先用小数据集跑通再上大索引。 还要知道:上游仓库已进入维护模式,官方明确它「不是受支持的产品」,只作方法论与演示。
常见问题
- 答案质量高度依赖所选的社区层级摘要。
- 打开「允许引入通用知识」开关会提高幻觉概率。
- 增量更新贵,默认路径是重新索引。
- 抽取阶段就把错误固化进图里了。
什么时候不够用
要的是「当前状态」而不是「文本里的说法」时。它的图是大模型从文档里抽出来的关于世界的陈述, 不是世界本身;要当前库存、当前额度、当前工单状态,必须走结构化那一侧。
本体平台:企业世界的镜像,每样东西能看、能改、有主人
前五种都在解决「怎么找到话说」。本体解决的是另一件事:此刻真实状态是什么、允许谁改、改完怎么收场。
它到底是什么
四类东西装在同一层:对象(客户、订单、批次)、关系(属于、涉及、依赖)、 动作(放行、调拨、派工,带规则与事务)、权限(谁能看哪一行哪一列、谁能提交哪个动作)。 数据从业务系统持续灌进来,改动再持续写回业务系统。
企业出现这些信号才选它
- 要把结论写回已有系统,不只是读。
- 要按人、按密级动态控制到行列级。
- 改动必须要么全成要么全滚,可审计可撤销。
- 要把模型和优化器当工具调用,而不是把数字抄进提示词。
- 要留决策记录:谁、在哪个数据版本上、做了什么决定。
怎么建
就是本稿第Ⅰ、Ⅱ、Ⅲ部分那条路:先找决策 → 建对象与关系 → 通管道与索引 → 加动作与事务 → 上权限 → 装检索 → 接智能体。 顺序不能换:先建检索再补动作与权限,会退化成「查得到但做不了」。
花多少钱
高,但成本在建模与治理,不在算力。官方文档专门列了一整章建模反模式,说明这笔钱主要花在「定义清楚」上。
常见问题
- 主键会变 → 对象身份断裂,历史全废。
- 索引延迟没测 → 业务看到旧数据,从此不信平台。
- 权限事后补 → 只能做粗粒度。
- 旁路写入 → 审计与权限同时失效。
它不替代前面五种
官方文档明确否定「本体就是更高级的数据目录或语义层」这种类比。成熟形态是本体 + 检索: 全文与向量负责找,关系负责遍历,动作与权限负责落地。
决策树
两个「本体」不是一回事
W3C 定义 OWL 本体为「术语的正式词表」——术语与公理层,可推理但不含业务数据; Palantir 的 Ontology 是「语义元素 + 动能元素(动作、函数、动态安全)」的运行时操作层。 谈选型时不要把这两个词混作一个含义。
第 0 问答案要不要改变业务系统?
A 结构化表,已有主键外键
B 非结构化文档,问的是局部事实
C 全局归纳型问题
D 输入已是维护良好的 wiki / 代码仓,用户是开发者
判据补一条:如果问题其实是「跨业务实体多跳 + 要落到当前状态」,GraphRAG 不够—— 它的图是从文本抽出来的「关于世界的说法」,不是世界本身。
五个常见误解,与「必须上本体」的五个硬信号
| 误解 | 事实 |
|---|---|
| 上了 GraphRAG 就等于有了本体 | 它的图是 LLM 从文本抽出的实体与说法,产物是供检索的社区摘要;没有权限模型、没有动作事务、没有回写 |
| 知识图谱 = 本体 | 图谱是一种数据组织方式,OWL 本体是术语与公理层;带实例数据 + 动作 + 运行时权限的操作层是第三样东西 |
| RAG 能回答「现在该做什么」 | 「该做什么」需要当前状态 + 判定逻辑 + 动作权限,三者都不在检索层里 |
| 权限在应用层加就行 | 向量库的过滤发生在索引扫描之后,图库权限通常只到角色与子图;把权限当后置过滤会泄露 |
| 本体就是高级数据目录 / 语义层 | 官方文档明确否定这个类比:本体不是语义层,也远超数据目录与 schema 设计 |
出现这五条,检索类方案救不了
- 需要写回已有系统(ERP / WMS / MES / 工单),而不只是读。
- 需要行 / 列 / 单元格级动态权限,且随身份组与密级在运行时计算。
- 需要动作有事务性:要么全成要么全滚,可审计、可撤销。
- 需要把模型与优化器当作可被调用的工具,而不是把数字塞进提示词。
- 需要沉淀决策数据:谁、在哪个数据版本上、通过哪个应用、做了什么决定。
反过来:什么时候不该建本体
- 需求只有「查资料」,没有任何写回与逐人权限 → 检索类方案更便宜。
- 数据量小、问题局部 → 官方都建议先无需索引。
- 没有业务方愿意为动作正确性负责 → 建了也没人敢写。
组合而非替代
成熟形态是本体 + 检索:全文与向量负责找,图谱式链接负责遍历, 动作与权限负责落地。本稿第二部分讲的检索层正是装在本体里面的那一层。
需求调研:把「决策」找出来
本体项目失败的第一原因不是技术选型,而是拿着一堆表开始建模。 第一部分给出可直接使用的访谈脚本、反推方法和一张盘点表。
代价最高的误区:把本体当成数据库建模
「我们有哪些系统、哪些表」是起点不是答案。本体建模的正确单位是「一次决策」—— 它天然要求数据、逻辑、动作、权限同时到位,缺一件就暴露出来。
表思维的三个症状
- 建模完成后无人使用,只有报表
- 对象定义照抄源系统字段
- 「权限以后再加」,结果永远加不上
判据一:能否指着一个对象说人话
如果不能对业务方说「这是 3 号仓库里那批待发的 240 台设备,卡在信用额度」,说明建的还是表。
判据二:能否回答「现在该做什么」
对象集必须能引出动作。只能查看的模型,最终退化为 BI。
判据三:动作出错能否回滚与追责
没有行动日志与撤销,业务方不会把真实流程交给你。
正确的最小单位
一条决策 = 一个对象集 + 一组判定逻辑 + 一个动作 + 一套权限 + 一次留痕。用这个五元组去数需求。
一个经验值
先做透 1 条决策闭环,再谈第 2 条。Palantir 官方 Onyx 示例本身就是单条闭环:仓库积压 → 折扣与调拨 → 写回 WMS / ERP。
Palantir 的建模范式:数据 / 逻辑 / 动作 / 权限 四位一体
这四者不是四个模块,而是同一个对象的四个面。任何一面单独存在都不构成可用的本体。
调研阶段就要四件一起问
- 数据:这条决策要合并哪几个源?谁是权威源?
- 逻辑:判定规则写在谁的脑子里 / 哪个 Excel / 哪段 SQL?
- 动作:决定后要在哪个系统做什么操作?谁有权做?
- 权限:哪些行、哪些列、哪些动作绝对不能给谁?
为什么「先做数据、逻辑以后补」必然失败
逻辑一旦散落在报表与脚本里,就会长出一套与对象无关的私有模型; 等到要接 AI 时,通常会看到没有任何一个「可被调用的动作」存在。 权限同理——事后附加只能做到粗粒度。
调研访谈脚本:四类问题
对象是「业务方本来就在说的名词」,不是设计出来的。所以访谈的目标是录下他们的动词和名词。
| 类别 | 提问句 | 听什么 | 映射到本体 |
|---|---|---|---|
| 找决策 | 「上周你做过的一次判断是什么?当时屏幕上有哪几个系统?」 「这个决定一周发生几次、一次多少钱?」 | 频率 × 影响面 = 优先级;多系统切换 = 数据缺口 | 场景 / 应用入口 |
| 找触发 | 「什么情况下你会被叫去看这件事?」 「你是被邮件叫醒,还是早上主动看一张表?」 | 阈值、时间、事件三类触发 | Automate 条件、对象集筛选 |
| 找例外 | 「这条规则什么时候会被你手动推翻?推翻后你要通知谁?」 | 例外 = 隐藏的对象与关系;通知 = 副作用 | 提交条件、审批、通知/Webhook |
| 找代价 | 「如果这个动作做错了,最坏结果是什么?谁负责纠正?」 | 代价决定隔离级别、确认要求、回滚粒度 | 动作规则、权限、行动日志 |
| 找名词 | 「你刚才说的『那批货』『卡单』具体指什么?怎么唯一确定一个?」 | 业务口语里的实体与主键 | 对象类型、主键、标题键 |
| 找边界 | 「哪些数字你绝对不能让别的部门看到?反过来呢?」 | 双向保密、单元格级限制 | 安全策略、强制控制属性、受限视图 |
访谈纪律:一次不超过 45 分钟;只问「上一次」不问「一般会」;结束前让对方在纸上写出他关心的 5 个对象名字。
从一条决策反推本体:决策五问
拿访谈记录里的每一条决策跑一遍五问,答案连起来就是本体草案。
① 谁决策?
角色 + 部门 + 上下游。→ 用户、组、项目、资源权限 与 数据权限 的初始矩阵。
② 看什么?
对象、字段、关联、历史。→ 对象类型 + 属性 + 链接类型 + 需要的索引与检索方式。
③ 动什么?
改哪个字段、建哪个新对象、通知谁、调哪个外部系统。→ 动作类型 + 参数 + 规则 + 副作用。
④ 谁能动?
可提交人群、需审批人群、绝对禁止人群。→ 提交条件 + 权限策略 + 确认要求。
⑤ 动完留什么痕?
谁、何时、依据什么、改成什么、是否撤销。→ 行动日志 + 编辑历史 + 决策血缘对象。
| 五问 | Onyx 示例:积压折扣决策 |
|---|---|
| 谁决策 | 区域库存经理(跨 3 个仓库) |
| 看什么 | 库存批次对象 + 关联订单 + 库龄 + 仓储成本 + 客户等级 |
| 动什么 | 提交折扣方案:改批次价、建调拨单、通知销售、写回 WMS 与 ERP |
| 谁能动 | 折扣 ≤15% 自主;>15% 需销售总监审批;财务只读 |
| 留痕 | 决策记录对象:输入快照 + 采用方案 + 结果指标(30 天去化率) |
五问跑不通的三种信号
- 答不出「动什么」→ 这不是决策,是报表需求,降级处理。
- 「看什么」需要 8 个系统 → 数据缺口,先排期接入而不是先建模。
- 「谁能动」有 5 个以上特例 → 组织规则未固化,先谈流程再谈系统。
需求盘点表:一张表定范围
八列,一行一条决策。这张表同时是建模输入、验收清单和汇报材料。
| 决策 | 触发 | 数据源(权威源) | 对象类型 | 关键属性 | 关系 | 动作 | 权限要点 | 价值指标 |
|---|---|---|---|---|---|---|---|---|
| 积压折扣 | 库龄>90 天 | WMS / ERP×3 | 库存批次 | 库龄·成本·客户等级 | 批次→订单→客户 | 提交折扣方案 | ≤15% 自主,>15% 审批 | 30 天去化率 |
| 缺货调配 | 预测缺口 | 计划系统 | 物料 / 仓库 | 安全库存·在途 | 仓库↔仓库 | 建调拨单 | 跨区需总监确认 | 缺货损失额 |
| 设备停机响应 | 阈值告警 | SCADA / 工单 | 设备 / 工单 | 状态·OEE | 设备→产线→订单 | 派工 + 顺延交期 | 车间可见,财务不可 | 停机时长 |
| 信用挂单 | 下单时 | ERP / 征信 | 客户 / 订单 | 信用额度·逾期 | 客户→订单→发票 | 放行 / 拒绝 / 提高预付 | 财务独占 | 坏账率 |
填表规则 1
「数据源」必须标权威源(system of record)与同步频率;一个属性有两个源就必须先定裁决规则。
填表规则 2
「对象类型」只写业务名词,禁止写表名。写了表名说明还没想清楚。
填表规则 3
「价值指标」必须是可自动采集的数;填「效率提升」的行列出来重做。
范围控制与开工检查单
本体项目最常见的失败方式是「平台先建好,业务再进来」。用四条硬标准砍需求,用 12 项绿灯决定要不要开工。
砍需求的四条硬标准
- 无动作:只读不写的需求,交给 BI,不进 V1。
- 无权威源:数据没有明确 system of record,先做治理再做对象。
- 无 owner:没有具体的人愿意为动作正确性负责,不建。
- 无度量:价值指标无法自动采集,不建。
V1 的合理体积
1 条决策闭环 · 8–15 个对象类型 · 1–3 个动作 · 2–4 个数据源 · 1 个真实用户小组。 超过这个量级,索引重建、权限调试和动作回归的周期会吃掉整个迭代。
| # | 开工检查项 | 不过关的后果 |
|---|---|---|
| 1 | 决策清单已按价值指标排序 | 做出来没人用 |
| 2 | 每个对象指定唯一权威源 | 同一对象多版本冲突 |
| 3 | 主键选定且「不会变」 | 索引重排、历史断裂 |
| 4 | 标题键选定(人眼识别用) | 界面全是 ID |
| 5 | 动作与提交人明确 | 只能看不能用 |
| 6 | 数据权限矩阵初版存在 | 上线即越权 |
| 7 | 敏感列识别并标记 | 泄露不可挽回 |
| 8 | 增量更新机制确定 | 全量重跑拖垮索引 |
| 9 | 对象量级与查询形态已知 | 选错执行路径、超时 |
| 10 | 撤销 / 回滚策略确认 | 业务方不敢用 |
| 11 | 验收指标可自动采集 | 无法证明价值 |
| 12 | 有一个真实用户小组 | 闭门造车 |
本体构建:从对象到可写系统
十三页技术细节。顺序即依赖顺序:先定语义(对象/属性/关系/接口),再通管道(接入/索引/健康), 然后给出手(动作/逻辑),最后套上笼子(权限/检索)与大脑(模型/情景)。
三层结构:语义 / 动能 / 动态(以及另外两种「三层」)
Palantir 文档里「三层」有三种不同口径,混用会吵架。先消歧,再讲产品叙事的那一层。
口径 A · 本体内部三层(本稿主线)
语义层:对象、属性、关系、接口——世界是什么。
动能层:动作、逻辑、自动化——能对世界做什么。
动态层:模型、情景、决策捕获——世界会怎样、我们选了什么。
口径 B · 平台三层
Apollo(交付运维)/ Foundry(数据与本体)/ AIP(AI 层)。这是部署与产品边界,不是建模边界。
口径 C · 数据视角三层
数据集层(原始/清洗)→ 对象层(本体索引后)→ 应用层。工程沟通常用,别和口径 A 混着写进设计文档。
设计要点:三层是「同一次建模的三个纵切面」,不是三个阶段。语义层改了,动能层的动作参数要同步; 动态层的模型输出要能落成属性或动作参数,否则模型接了也白接。
对象类型:三种标识 + 两个键,决定后面一切
对象身份的稳定性是本体的地基。RID、ID、API name 各有用途,主键与标题键一旦选定就很难改。
| 标识 | 形态 | 用途 / 稳定性 |
|---|---|---|
| RID | 资源标识符 | 平台内部唯一资源,跨环境不保持;权限与引用用它 |
| ID(对象主键值) | 业务值 | 对象在类型内的唯一身份;索引与去重依据 |
| API name | 可读别名 | OSDK / API / 函数签名用它;改名会破坏代码契约 |
| 键 | 要求 | 常见错法 |
|---|---|---|
| 主键 Primary key | 类型内唯一、非空、不随业务变化 | 用状态、用可改的工单号、用拼接串后期加减段 |
| 标题键 Title key | 人眼可识别,可重复 | 留空或选内部编号,界面全是 UUID |
基础类型
Boolean / Byte / Short / Integer / Long / Float / Double / Decimal / String / Binary / Date / Timestamp / Geohash / Geopoint / Geopolygon / Array / Struct。
对象集两种形态
静态:固定成员。
动态:保存的是筛选条件,数据一变集合自动变。
自动化触发几乎都该用动态集。
临时 vs 永久
查询产生的对象集默认临时;要跨会话/共享/触发器引用需显式保存。保存后要负责它的维护。
四个反模式
- 一个对象类型装所有物料(属性稀疏)
- 把报表指标建成对象
- 主键用自增,跨源合并即冲突
- API name 起得太长,函数签名没法读
命名纪律:类型用业务名词(InventoryBatch),属性用业务口径(daysOnHand 而不是 f_col_3); 源字段名在管道层处理,不要泄漏到本体。
属性进阶:结构体、值类型、派生、只读与强制控制
属性不是字段列表。它承载口径(值类型)、组织方式(结构体)、计算(派生)和治理(必填 / 只读 / 强制控制)。
| 机制 | 解决什么 | 关键约束 | 什么时候用 |
|---|---|---|---|
| 结构体 Struct | 把成组属性打包成一个整体(地址、金额+币种、GPS+精度) | 结构体内属性共享空值语义;检索与权限支持面窄于普通属性,用前先验证 | 多字段总是成对出现时 |
| 值类型 Value type | 给属性绑定业务口径与校验(邮箱、SKU、百分比、币种) | 格式校验在写入期生效;一旦广泛使用,改动影响面大 | 同一语义在多类型重复出现,需统一口径 |
| 共享属性 | 跨对象类型复用同一定义(如 status、updatedAt) | 改名/改类型影响所有引用它的类型与接口 | 需要跨类型统一检索与统一映射 |
| 派生属性 | 由其他属性/关系计算得出 | 计算时机与新鲜度必须显式说明,否则 LLM 会当权威值引用 | 口径唯一且成本可承受 |
| 必填 / 只读 | 写入约束 | 只读要区分「管道只读」与「动作只读」,含义完全不同 | 任何会被动作修改的关键字段 |
| 强制控制属性 | 该属性的值决定对象对谁可见 | 属于安全策略机制,改动需安全评审;不是普通业务开关 | 密级、组织归属、区域等行级隔离依据 |
选型口诀
成组 → 结构体;有格式 → 值类型;跨类型同义 → 共享属性;纯算出来 → 派生;决定可见性 → 强制控制。
不要把逻辑写入属性名
isDiscountEligibleIfAgedOver90AndMarginBelow10 这种命名是债。口径属于逻辑层,属性只存事实。
常见问题
- 数组属性检索/聚合支持有限
- Decimal 与 Double 混用导致对账差
- 时间戳不带时区,跨区业务算错库龄
关系建模:三种实现 + 「过程对象 / 日志对象」范式
链接不是外键的同义词。选错实现,遍历性能、可写性和权限继承全都会出问题。
① 外键链接
子对象存父对象主键。一对多最简单,写入由管道或动作维护。
适合 订单→客户、设备→产线
② 连接表链接
独立关联数据集承载多对多,可带关系属性。
适合 物料↔供应商、人员↔技能
③ 对象支撑链接
把关系本身建成对象,于是关系可以挂属性、被动作修改、被检索。
适合 需审计或参与流程的关系
Titan 过程挖掘给出的最小可用模型
做流程分析不需要接流程引擎,只要两张对象类型:
// 过程对象:一次流程实例
Process    { processId PK, caseRef, state, startedAt, closedAt }

// 日志对象:一次状态迁移
ProcessLog { logId PK, processRef FK,
             state, timestamp, actor, reason }

// 本稿 demo 的过程对象:一次发货
Shipment { id PK, sales_order_id FK, from_region_id FK,
           to_customer_id FK, departed_at, eta_at, arrived_at,
           status ∈ {in_transit, delayed, delivered} }

// 「延迟」不是贴上去的标签:eta_at < 演示日 且未到达,状态由时间推出

// 官方强调:其实只需要三列(对象主键 + 当前状态 + 时间戳)
有了这三列,就能自动生成流程图、瓶颈时长、返工率与例外路径——把「实际发生的流程」变成可查询对象。本稿据此建了 Shipment,换来地图上的在途弧线与「敞口中有多少是路上的货」(49,734.4 万,与逐客户敞口的在途桶同账)。
关系设计四条纪律
- 命名从阅读者视角:订单.属于.客户,避免语义歧义。
- 基数要写出来,否则界面会造出「点击展开 20 万条」。
- 关系属性优先用对象支撑链接承载,可写可审计。
- 遍历成本先估:一跳扇出 >1000 的关系要设计中间聚合。
接口与共享属性:让「不同东西」能被同一套逻辑处理
接口是本体里最被低估的抽象。它给多个对象类型一份共同契约,于是检索、遍历、动作参数和 AI 工具都能写一次。
接口解决什么
「所有可延期对象」「所有有 SLA 的东西」「所有需审批的变更」—— 这些跨类型的共性若无接口,只能在每个应用里重复 if-else。
共享属性是接口的砖
接口声明需要哪些属性;对象类型通过共享属性满足契约。属性名一致 ≠ 契约一致,必须显式映射。
用前必查
- 并非所有能力都对接口开放(聚合、部分检索、动作参数类型受限)
- 动作的目标类型需为具体类型而非接口
- 契约变更会波及所有实现类型,属破坏性变更
| 写法 | 没有接口 | 有接口 |
|---|---|---|
| 检索「所有逾期项」 | 三次查询 + 应用层合并 + 各自排序 | 一次按接口的对象集查询 |
| AI 工具「列出我逾期的东西」 | 每个类型一个工具,LLM 需先选类型 | 一个工具,参数空间小、误调用少 |
数据接入与索引:对象不是表,中间有一条管道
数据集 → 对象是可查性的关键一跳。理解这条管道,才能解释「为什么改了源数据界面没变」「为什么全量重建会失败」。
默认走增量,代价有阈值
增量管道在变更比例过大时触发全量重建;官方口径里存在约 80% 的阈值说法。 手动编辑在合并阶段优先保留,但 replacement 管道会冲掉它。
流式与直连
流式对象类型有每类型带宽量级限制(官方示例约 2 MB/s)与 Flink 秒级检查点; 直连数据源为 beta,回放会清空视图,不要拿去接已投产对象。
多源裁决(MDO)
同一对象多源合并时,「缺失」与「空值」语义不同;未参与的源不要写 null, 否则会把有效值抹掉。裁决顺序必须写进设计文档。
执行分层决定查询体验
Object Set Service 三级:能下推的下推到存储 → 中等结果集内存处理 → 大结果集交给 Spark。写查询时按「预计返回规模」选择形态。
新鲜度是可承诺的指标
把「源到对象可见的端到端延迟」当成 SLO 量出来; 不同步的话,AI 的回答正确性无法保证。
四个管道层反模式
- 源字段直接映射成属性名
- 无主键裁决规则就上多源
- 把清洗逻辑放进派生属性
- 从不测索引延迟
数据健康、血缘与「数据即代码」
Titan 系列第一部分讲的就是这件事:本体能不能上线,取决于你敢不敢让别人相信里面的数。
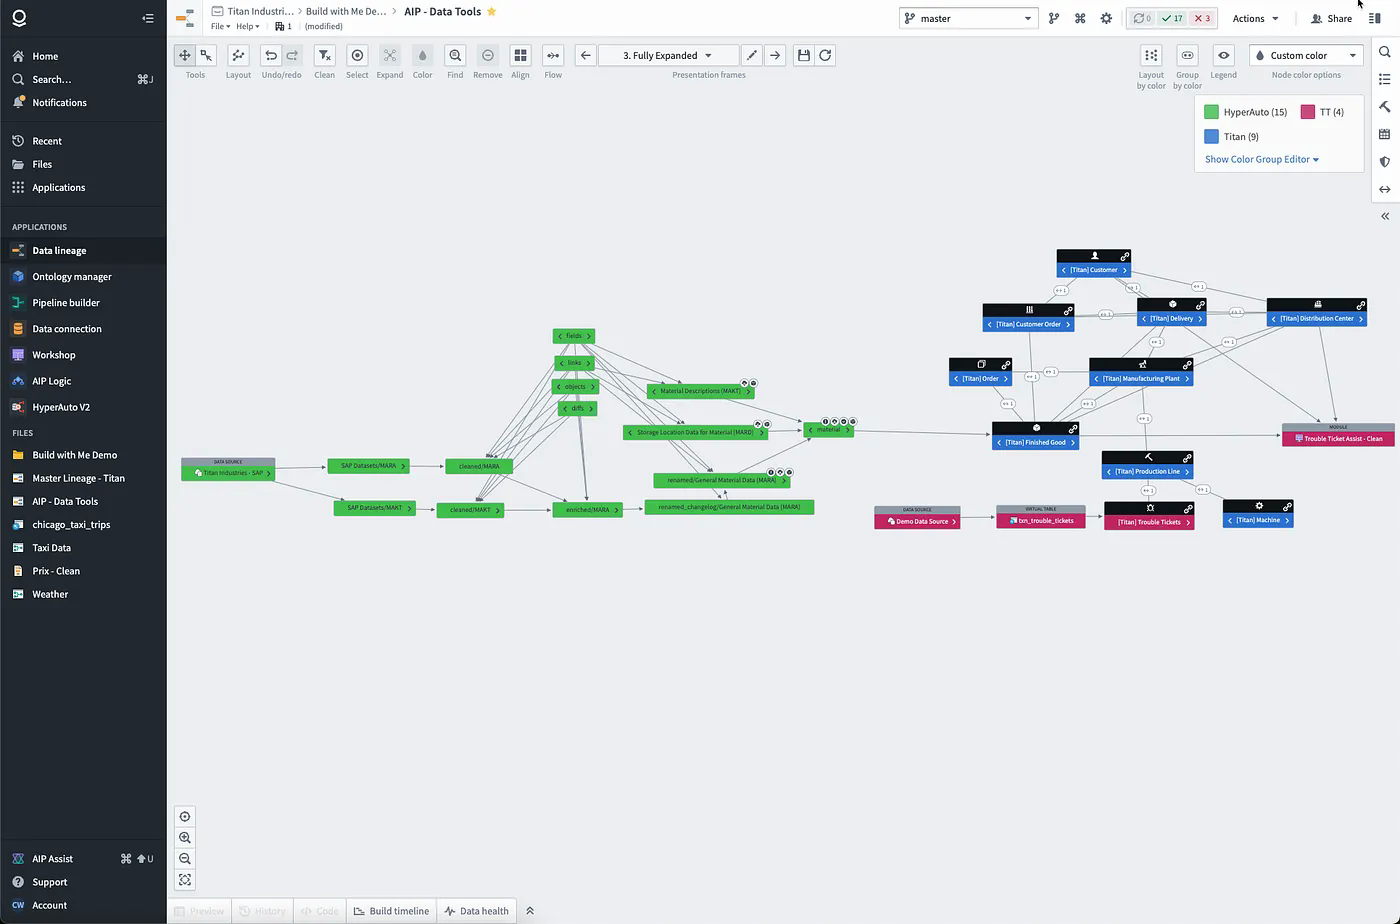
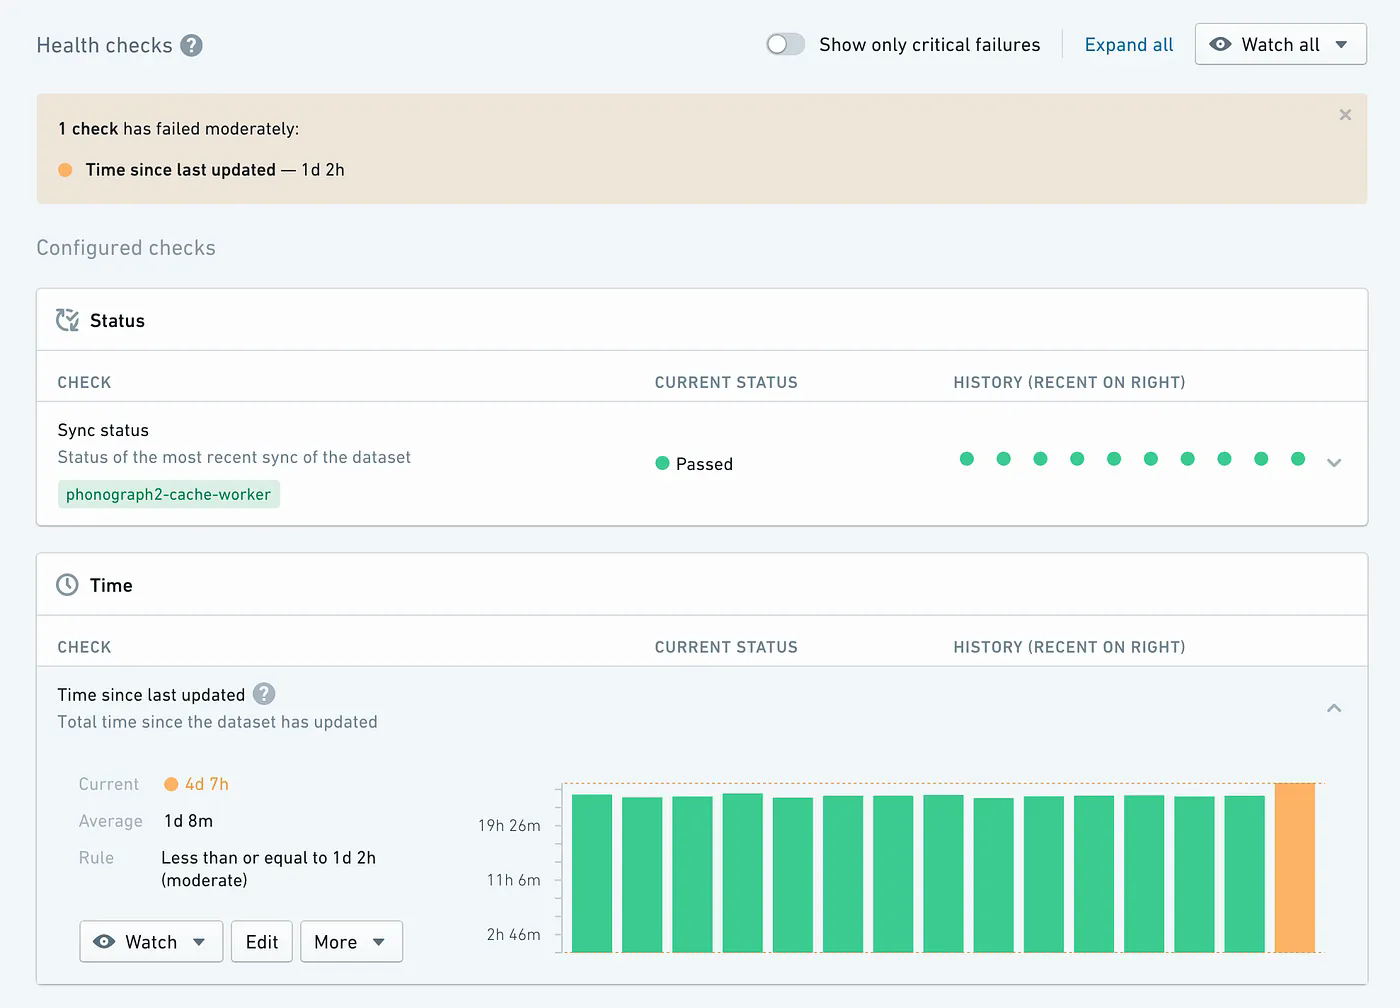
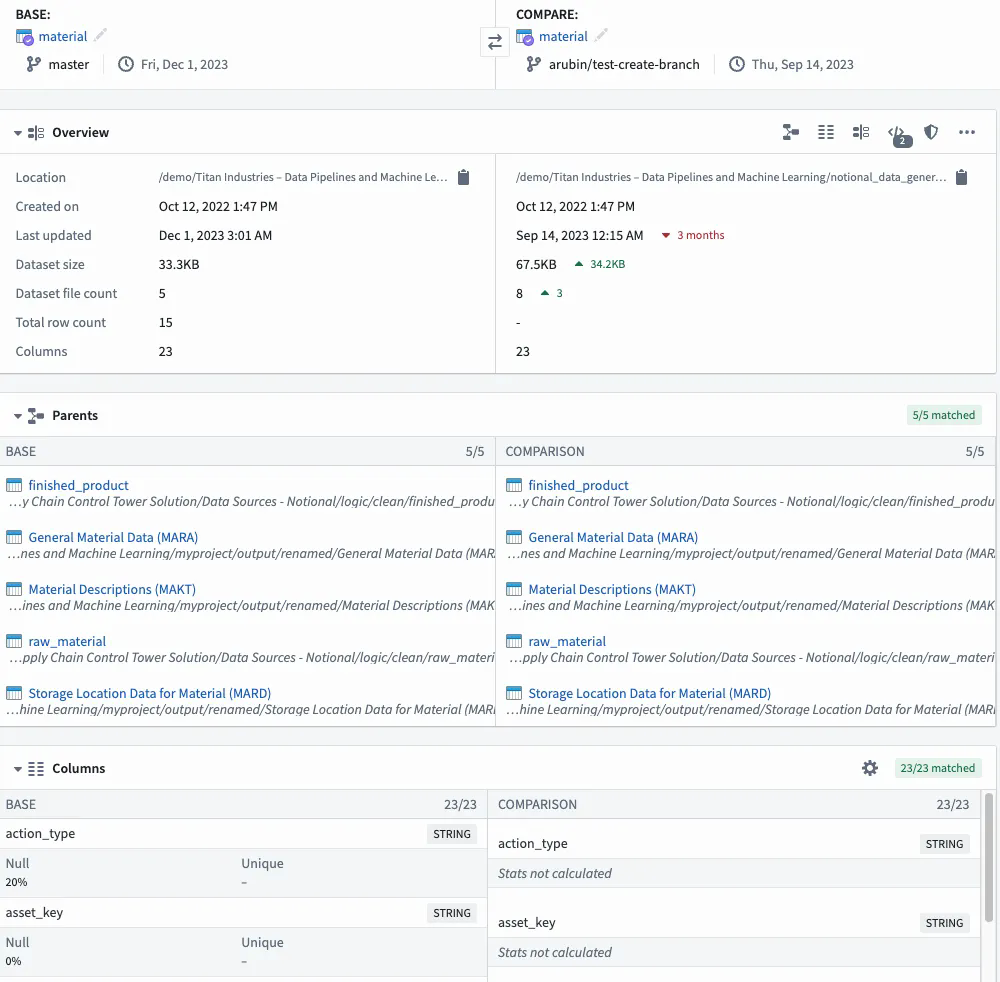
把健康度建成对象,而不是建成告警
告警会淹死人;对象不会。健康检查产出的是一条 DataQualityCheck 对象 (关联数据集 / 对象类型 / owner / 状态 / 最近通过时间), 于是它能被检索、被列表化、被动作修改、被 AI 当上下文引用——「这条数据可信吗」变成一个可查询问题。
分支工作流四步
- 在分支上改管道 / 本体
- 对比:schema diff + 样本对象 diff + 受影响应用清单
- 评审合并
- 保留回滚点
本体迁移(类型改名、主键变更、属性迁移)是破坏性变更,必须走显式迁移而不是「直接改」。
Action:本体的手
动作 = 一次受控的、可审计的业务变更。它是「规则 + 参数 + 谁能提交 + 提交后干什么 + 出错怎么办」的打包。
五个组成
- 规则 Rules:改哪个对象/属性、建不建新对象、删不删链接。
- 参数 Parameters:用户/AI 传入,带类型与校验。
- 提交条件 Submission criteria:不满足直接拒绝,错误信息给到人。
- 副作用 Side effects:通知、Webhook、触发调度。
- 执行上下文:真实环境 or 情景(scenario)副本。
ACID 与隔离级别
动作以事务提交。隔离级别有历史默认与更弱读取一致性的选项, 取舍是「性能 vs 写偏(write skew)」。涉及互斥判断的动作必须用最严的那档。
幂等与重试
至少一次语义意味着重复提交是常态。 外部副作用要自带幂等键;批量写 与 分阶段写 在失败可见性与回滚粒度上不同。
| 机制 | 要点 | 常见错误与规避 |
|---|---|---|
| 动作日志 Action log | 谁/何时/参数/结果,可按对象审计 | 当成业务历史用,结果受保留期限制 |
| 编辑历史 Edit history | 对象级属性变更序列 | 与动作日志混淆,导致归因错误 |
| 撤销 Revert | 反向补偿而非抹除 | 撤销已发出的 Webhook 外部副作用(撤不回) |
| 函数产生的编辑 | 函数里的本体修改只能通过动作生效 | 在函数里直接改并期待持久化 |
| 读写授权分离 | 能读 ≠ 能改(部分能力仍在演进) | 以为给了查看权限就能提交 |
| 情景执行 Scenario | 在副本上试算,不污染生产 | 把推演结果当承诺发出去 |
动作设计四条硬规矩
- 一个动作只做一件业务事,禁止「万能更新」。
- 提交条件写「业务规则」而不是「非空校验」。
- 有外部调用的动作必须有幂等键与失败可见性。
- 给 AI 用的动作要么需要确认,要么参数空间极窄。
Logic 与 Action 都「像预定义函数」,为什么必须分开
区别不在形态,在契约:Logic 回答「是多少 / 该怎么办」,可以很复杂但没有写入权; Action 回答「就这么改了」,简单但有事务、权限与审计。
| 维度 | Function / AIP Logic(逻辑) | Action(动作) |
|---|---|---|
| 本质 | 纯计算:输入 → 输出 | 受控变更:输入 → 事务 + 副作用 |
| 是否写本体 | 可产生编辑意图,但必须经动作提交才生效 | 是写入的唯一入口 |
| 权限语义 | 跟着函数的资源权限走 | 跟着「谁能提交这个动作」走,可细到提交条件 |
| 审计 | 调用日志 / trace | 动作日志 + 编辑历史 + 撤销 |
| 失败语义 | 返回错误或超时 | 整个事务回滚,用户看到拒绝原因 |
| 适合承载 | 评分、判定、优化、模拟、聚合、查询函数 | 改价、派工、放行、调拨、审批 |
| 给 LLM 当工具 | 只读工具:让模型「算一下」 | 写工具:让模型「做一次」,需确认与幂等 |
逻辑的三种实现
TypeScript v1/v2:与对象类型绑定的强类型函数。
Python:数据科学 / 优化。
AIP Logic:块 + 工具的无代码 LLM 编排,面向业务人员。
组合范式:Logic 判,Action 落
「逻辑算出建议 → 动作带提交条件与事务把它落地」。 自建平台一定要保留这条边界:判定可以试算、可以并行、可以只读;落地必须唯一入口。
版本、快照与限制
函数有语义化版本与快照;执行有强制上限(含 AIP Logic 常规运行约 5 分钟量级, 调试器内例外)。长任务拆到批处理或计算模块,不要塞进函数。
权限层:三条轴,两个陷阱
本体的安全不是「谁能登录」,而是「谁能看见哪一行哪一列、谁能提交哪个动作」。
轴一 · 资源权限
谁能动这个「东西」:数据集、管道、本体类型、应用、动作定义。 来源可以是项目成员、本体角色或数据源继承。
轴二 · 数据权限
谁能看这些「行/列」:对象安全策略与属性安全策略,支持行级、列级、单元格级, 在读时生效。
轴三 · 动作权限
谁能提交、在什么条件下提交、提交后能触发哪些副作用。 读权限与写权限可分离,但不要把「能看」当「能改」。
| 机制 | 做什么 | 注意 |
|---|---|---|
| 强制控制属性 | 属性值决定对象可见范围 | 属安全评审范畴,不能当业务字段随手改 |
| 受限视图 | 整类型对未授权者不可见 | 会影响关联查询的结果完整性 |
| MDO 空值语义 | 多源合并时的「未知」 | 不是零、不是缺失,别在逻辑里当 false 用 |
| 日志密级 Marking | 合规隔离 | 不会自动传播到衍生产物 |
陷阱一 · NOT 条件 + 窄权限 token
「除 X 之外都能看」这类否定条件,在外部集成的受限凭证下可能反转成 放开本该限制的数据。设计规则一律写正向白名单。
陷阱二 · 权限是产品的一部分
把「谁能看什么」做成可查询对象(授权记录、策略变更历史), 而不是散落在 30 个小组的角色配置里。审计提问当天答不出就是风险。
检索层:让对象「找得到」,AI 才「用得上」
搜索不是免费得到的。哪些属性可搜、怎么排、向量怎么用、混合结果怎么合,都要显式设计。
| 能力 | 用途 | 设计要点 |
|---|---|---|
| 关键词 / 排序检索 | 精确名、编号、短语 | 可搜索属性要显式挑;不要指望全属性默认生效 |
| 语义检索(向量) | 描述、工单文本、故障现象 | 向量维度受上限约束,超限直接不可用;只用于相似匹配 |
| 混合检索 + RRF | 既要准又要全 | 倒数排名融合,权重需按业务实测调 |
| HyDE / 查询扩展 | 用户问法与库内表述不一致 | 生成假想文档再检索,提召回但增噪声 |
| 对象集遍历 | 沿链接跳一跳 | 扇出规模决定是否走内存 / Spark 路径 |
OAG 的检索三步
- 把自然语言映射到对象类型 + 属性 + 关系(本体给了词表,LLM 不用猜 schema)
- 检索得到对象集,而不是文本分片
- 对象集成为下一步上下文:可继续遍历、可直接喂给动作参数
把「不可检索」当缺陷管理
每个对象类型列一份检索验收清单:主要查询场景是什么?命中率如何? 检索不到的业务问题,等于模型不存在。
性能红线
- 预估结果集规模决定执行路径
- 大范围遍历前先加过滤而不是先排序
- 给 AI 的检索工具必须带返回上限
动态层:模型、预测与情景推演
模型不是外挂。要么它的输出落成属性能被动作使用,要么它作为逻辑工具被调用,否则接了也只是个展示。
模型接进本体的三条路
- 预测 → 属性:批量打分写回,成为可检索、可过滤、可权限化的事实。
- 模型 → 逻辑工具:Titan 的 Prophet 预测被包成 AIP Logic 的工具,LLM 推理时按需调用。
- 模型 → 动作提交条件:让「预测缺货则不允许承诺交期」这类规则真正生效。
Titan 的目标建模(Modeling Objective)
一次训练 27 个模型变体,用固定评估子集比较,配评审关卡,从暂存环境推到生产。 关键词不是算法,而是「模型也有发布流水线」。
情景 Scenario = 平行世界
动作可指定在情景上下文中执行,于是能问「假如这样调拨,交付率 / 成本会怎样」。 试算不落生产,是本体版的 what-if。
| 层 | 组件 | 落地要点 |
|---|---|---|
| 特征 | 对象属性 + 关系聚合 + 时间窗 | 特征即属性,保证口径唯一与权限一致 |
| 训练 | 批处理 / 计算模块 | 版本、数据集快照、可复现 |
| 部署 | 打分管道 or 服务化工具 | 新鲜度承诺写进 SLO |
| 监控 | 漂移 / 覆盖率 / 命中质量 | 异常建成对象而非只发告警 |
| 治理 | 评审关卡 → 暂存 → 生产 | 模型变更也是本体变更 |
动态层四个坑
- 预测值当事实参与审计(应区分「预测」与「承诺」)
- 模型更新后历史回答无法复现
- 试算结果被截图当决策依据
- 特征直接绕开本体从源表取,权限失控
核心工程问题:重点、难点、痛点、常见问题与数据质量
上一章讲「怎么建」,这一章讲「为什么建不成」。 五类问题出现在不同阶段,混在一起谈会失焦,所以先给一张定位图。
重点:五件一次做不对、后面全是债的事
判断「是不是重点」的标准只有一条:以后能不能便宜地改。这五条都不能。
| 重点 | 为什么不可妥协 | 做错的代价 | 一次做对的做法 |
|---|---|---|---|
| 对象身份 | 主键有两条互相独立的硬要求:唯一(重复即索引失败)与确定(不确定会丢用户编辑、断链接) | 换主键等于重建身份:历史动作对不上、下游引用断裂;官方迁移指令不支持主键 | 用业务上不会变的自然键;官方明确禁止用行号或随机数生成主键 |
| 属性归属 | 多源对象是列向拼接:一个属性只能来自一个数据源(主键除外),平台不做冲突裁决 | 归属没定 → 同一事实两处不一致,且没人能解释谁赢;缺记录的属性显示为空值 | 建模时逐属性写清来自哪个源;需要行向裁决的改用视图层先去重 |
| 唯一写入口 | 审计、权限、事务都挂在动作上;旁路写入会让三者同时失效 | 事后无法解释「这条数据怎么变成这样的」,合规事件无法定量 | 只允许动作改本体;管道写入与人工编辑分开治理,且都留痕 |
| 权限前置 | 数据一旦扩散就收不回;行列级策略只能在新建时干净地落 | 敏感列被下游报表、导出、缓存复制出去,只能靠删数据补救 | 建模评审与安全评审同一次做完;策略用真实用户跑一遍再上线 |
| 新鲜度可承诺 | 业务与智能体都按「多快能看到变化」决定行为 | 用户看到旧数据后不再信任平台;智能体基于旧值给出建议 | 把源到可查的端到端延迟当服务目标量出来、配监控、写进验收 |
共同点
五条都不是技术难度高,而是需要业务方在场才能定。缺业务方时把它们挂起,不要用默认值硬填。
怎么验证做对了
拿三条真实业务问题做任务型演练:让没用过系统的人只靠通用工具找答案,记录卡在哪、搜了什么词、要不要手动导出拼接。
官方划的三条不可妥协线
官方承认理想设计不总能达到,允许在实现细节上取舍,但点名命名质量、语义清晰、安全设计三项「以后很难改」——这三处走捷径,等于给未来埋单。
难点一:粒度——太粗没人用,太细跑不动
官方给的四条原则能定方向,但落不到「这个字段到底建不建对象」这一层。下面是可操作的判据。
| 原则 | 落到日常怎么做 |
|---|---|
| 建模现实世界,不建模源表 | 先问「业务方提到它时指的是一个东西还是几个」,再决定拆不拆 |
| 同一概念出现三次就重构 | 重复的属性和逻辑第三次出现时,抽共享属性或接口 |
| 开放扩展、关闭修改 | 新能力靠加类型/链接/接口,不靠改核心类型的既有字段 |
| 组合优于深继承 | 用多个聚焦的小接口拼能力,不做五层类型树 |
三种归属的判据
- 存成属性:只描述这个对象自己,且不会单独被查、被改、被关联。
- 建成关系:它自己也有属性、有历史、会被单独提问。
- 做成派生:能从别的对象算出来,且会随对方变化而过期。
八种官方点名的反模式(自查)
- 系统孤岛:每个源系统建一个同名类型
- 杂物抽屉:把技术元数据、内部编号做成业务属性
- 部门孤岛:销售、财务各建一个客户类型
- 上帝对象:一个类型代表五种完全不同的东西
- 顺手锤:所有问题都用同一类工具解决
- 动作碎片:每个属性配一个「设置某值」动作
- 时光机:同一实体的每个版本建一个对象
- 词不达意:Item、Value、Type、Related Items 满天飞
扇出预算:把「太细」变成可算的数
对每条关系估一次「从一个对象跳过去会带出多少条」。一跳超过千级就要设计中间聚合或改成属性; 这一步做在前面,比上线后被慢查询倒逼重构便宜得多。
难点二:同一个东西在三套系统里,怎么变成一条
并购成长的企业几乎必踩。这一步没做扎实,后面所有聚合、所有智能体回答都在算错的东西。
先纠正一个常见误解:本体层不做实体消解
官方文档里没有「实体解析 / 黄金记录 / 幸存裁决」这类原语,只在架构页承认要与外部主数据管理工具做元数据互通。 本体层的多源对象只是「列向拼接」:一个属性只能来自一个数据源(主键除外),行向合并官方不支持、流式类型也不支持, 某源缺这条记录时该源属性显示为空值——和「没权限」长得一模一样,极易误判。 真正的去重与裁决发生在数据工程层。
三层解法,从便宜到贵
- 一、统一编号:源系统已有全局唯一键,直接当主键,成本最低。
- 二、视图层裁决:用带主键的视图保证唯一,再用排序列决定谁幸存、用删除列做软删;先去重再判删。
- 三、匹配与消解:名称规范化后组合打分,低置信进人工复核;这一步通常落在外部主数据工具里。
顺序别反:能在第二层解决的,不要上模型。
一个判断标准
「同一实体在平台里是一条还是几条」必须由数据层的确定性规则回答, 不能留给每个应用自己判断——否则同一客户在不同报表里就是两条。
| 议题 | 官方口径 | 工程含义 |
|---|---|---|
| 多源对象合并方式 | 只支持列向拼接;行向不支持,改用受限视图 | 想「多个源各出一行选一条」不该指望本体 |
| 同一属性多源提供 | 不允许,一个属性只来自一个源(主键除外) | 归属必须在建模期定,运行时无裁决 |
| 某源缺这条记录 | 该源属性显示为空值 | 与「无权限」同形,排查时先看归属再看权限 |
| 增量数据集去重 | 最近交易胜出;同一交易内不得有重复主键 | 管道里要先用窗口函数把一交易内的重复压掉 |
| 删除标记 | 删除列需按约定声明才生效 | 自己造一列「是否删除」默认不起作用 |
| 自动清洗 | 空串转空值、高精度小数转双精度、非标准主键列强制转字符 | 主键被转成字符串后会失去可比性,要显式检查 |
怎么知道做对了
三个数:重复率(同一实体几条)、错合率(不同实体并成一条)、人工复核占比。 错合比重复更危险——它看起来一切正常。
难点三:模式一定会变,难的是分清可逆与不可逆
本体上线三个月后必然要改。真正的问题不是「能不能改」,而是哪些改动没有回头路。
| 变更类型 | 可逆性 | 必须做的动作 |
|---|---|---|
| 新增对象类型 / 属性 | 可逆 | 正常评审;确认索引与权限同步跟上 |
| 改显示名、描述、图标 | 可逆 | 无需迁移 |
| 新增链接类型 | 基本可逆 | 确认基数与扇出,避免上线后被大量使用 |
| 改属性类型 | 不可逆风险 | 显式迁移 + 下游代码与动作同步改 |
| 改主键 / 改属性标识 | 不可逆 | 等同重建对象身份,需要专项方案 |
| 拆分 / 合并对象类型 | 不可逆 | 先建新类型双写,再切读,最后停旧 |
| 接口契约变更 | 破坏性 | 波及所有实现类型与依赖它的工具 |
官方给的变更清单与两条硬约束
破坏性变更与非破坏变更各有成文清单,并提供八类预定义迁移指令;但一次最多 500 条迁移,且迁移指令不支持主键属性——改主键在两个存储版本上都是编辑历史的毁灭点。
安全改动的四步套路
- 在分支上改,生产不受影响。
- 对比:模式差异 + 样本对象差异 + 受影响应用与工具清单。
- 需要双写的,先双写一个窗口期,验证一致再切读。
- 合并后保留回滚点;不可逆项在评审时就标红。
迁移期最容易丢的东西
- 人工编辑历史:迁移可能只带走数据,不带走编辑记录。
- 关联资源:类型迁了,动作、视图、应用没跟着迁。
- 索引状态:迁移后没重建索引,查询结果与预期不符。
- 十进制精度与标度:换类型时静默截断。
一个判断标准
问「这个改动之后,三个月前那条动作记录还能不能解释」—— 不能解释的,都是不可逆变更,都要走专项评审。
难点四:性能不是调出来的,是建模时定出来的
同一个查询,结果集规模决定它走哪条执行路径。建模时不估规模,上线后只能加机器或砍功能。
| 症状 | 根因 | 解法 |
|---|---|---|
| 界面转圈、超时 | 默认把「所有」拉回来再过滤 | 先过滤后遍历;给每个查询加返回上限 |
| 关联查询忽快忽慢 | 某一跳扇出过大 | 建模时估基数;大扇出改走聚合对象 |
| 过滤条件一加结果就变少 | 向量类检索的过滤发生在扫描之后 | 把过滤前移到索引键或改成结构化检索 |
| 索引重建拖垮窗口 | 变更比例过大触发全量重建 | 控制批量改动节奏;把大批量写拆成多次增量 |
| 派生属性一过滤就慢 | 派生值不进索引 | 需要高频过滤的值改为管道预计算属性 |
| 大字段拖慢一切 | 长文本、大数组塞进对象 | 大内容走媒体引用;大集合改成关系 |
| 批任务把交互挤爆 | 未做资源隔离与配额 | 批处理错峰、给交互流量留配额、模型调用限流 |
三条设计期纪律
- 每个对象类型标注预期规模与典型查询形态。
- 每条关系标注基数与扇出预算。
- 每个高频过滤字段确认是否进索引。
把阈值当输入而不是意外
官方写死的几条:结果集约十万量级时从内存执行切到分布式执行;关联查询的叶子集合与跨集合计分别有上限; 类型化客户端一次拉全量的上限同为十万量级;单次加载上万对象就可能让函数超时; 估算值超过阈值两倍会在真正撞墙前直接失败。写入设计文档,比线上回推便宜。
口径冲突要实测
官方不同页对关联查询的规模上限、结构体在检索列上的支持存在不一致说法。 凡影响架构决策的数字,都要在自己环境跑一次基准,不要引用文档值当结论。
痛点:数据质量不是「尽量干净」,是六个可判定的要求
本体对数据质量的要求比报表高一个量级——报表算错只是看错,本体算错会被写成新的业务事实,再回写源系统。 六维是数据管理领域的通用划分,右三列落到本体的具体机制。
| 维度 | 白话含义 | 对本体的具体要求 | 怎么检测 | 不达标怎么办 |
|---|---|---|---|---|
| 完整性 | 该有的值都有 | 主键、标题键、强制控制属性、参与动作判断的属性不得缺失 | 逐列非空率;按对象类型出「必填缺口清单」 | 阻断入索引;缺主键的行进隔离区,不进对象 |
| 唯一性 | 一个东西一条记录 | 主键在类型内唯一;跨源合并后不出现重复实体 | 主键重复计数;实体重复率抽样审计 | 回管道层做去重与裁决,禁止在应用层「取第一条」 |
| 时效性 | 看到的就是现在的 | 源到可查的端到端延迟在承诺范围内;关键属性有新鲜度目标 | 延迟分位数监控;对照服务目标告警 | 降级展示「截至 X 时刻」,并禁止智能体引用过期值作答 |
| 有效性 | 格式与取值合法 | 类型匹配、枚举在允许集合内、日期与时区正确、数值不越界;浮点不得为 NaN 或无穷 | 值类型约束 + 构建期数据期望(六类:主键、行数、值属于枚举、值非空、浮点非 NaN、行级) | 构建失败即拦截;不要「先入库再清洗」 |
| 一致性 | 多处说法相同 | 同一事实在多源、多表、多系统间口径统一;单位与币种统一 | 跨源对账差异表;单位/币种字段强制标注 | 定权威源并记录裁决;差异超阈值时冻结相关动作 |
| 准确性 | 值确实反映现实 | 属性值与真实世界一致(最难,也最容易被忽略) | 抽样人工核对 + 与权威外部源比对 + 业务反馈闭环 | 标注置信度;低置信值不参与动作提交条件 |
为什么必须是「要求」而不是「期望」
本体的三个特性把质量从软指标变成硬约束:对象身份唯一、动作基于当前值提交、 智能体把值当事实引用。任何一维失守,都会沿这三条路放大。
要求要写到字段级
「客户主数据质量要好」无法执行;「客户的统一社会信用代码非空、唯一、格式合法,且参与放行判断」可以执行、可以监控、可以追责。
别把六维混成一维
很多团队只做「完整性」,于是数据齐全但重复、及时但口径不一致。六维要分别有数、分别有人负责。
解法:把质量做成闸门和对象,而不是做成周报
质量问题一定会发生。区别只在于:它在进入本体之前被拦住,还是在业务出错之后被发现。
官方文档里明确写着:健康检查的最佳实践不覆盖数据的内容质量、准确性与有效性——也就是说,质量规则必须业务侧自己定义,平台只提供执行与拦截的位置。
| 闸门 | 机制 | 拦什么 | 不通过时的行为 |
|---|---|---|---|
| L0 建模声明 | 必填属性、值类型约束、强制控制属性、仅编辑属性、动作提交条件 | 声明层面的底线:必须非空、必须属于枚举、必须满足业务条件 | 保存能成功,重新索引时才失败——这是最迷惑的一种失败 |
| L1 构建期阻断 | 数据期望(代码或可视化管道两种配法) | 主键唯一非空、行数区间、取值集合、非空、浮点非 NaN、行级自定义、模式漂移 | 直接中断构建,脏数据不出管道 |
| L2 运行期告警 | 健康检查、数据健康、监控视图 | 状态、时间、体量、内容、模式五类异常 | 产生通知与工单,可对接值班与协作系统;不阻断 |
| L3 索引期硬校验 | 对象存储的索引期数据限制 | 空串、NaN 与正负无穷、数组内含空值、嵌套数组、非法顶层类型 | 批数据源整批失败;流数据源逐条丢弃违规记录 |
为什么必须有 L3
官方给的定性是:这些限制是为了保证进入本体的数据质量、行为更可确定、平台整体更易读。 换句话说,索引期校验不是 bug,是产品承诺的一部分——所以别指望「先塞进去再说」。
把质量做成对象,而不是周报
每条检查产出一条质量记录:检查项、目标、结果、负责人、最近通过时间、失败次数。 于是「这条数据可信吗」变成可查询问题,也能被智能体当上下文引用。
脏数据进了本体的连锁反应
- 人看到错值 → 回退到自己的 Excel
- 智能体引用错值 → 错误被规模化
- 动作基于错值提交 → 污染写回源系统
- 决策血缘记录错值 → 复盘失去依据
闸门上六个反直觉的细节,每一项都容易引发故障
这些不是理念问题,是官方文档里写明的行为。知道的人五分钟避开,不知道的人排查一天。
| 细节 | 官方行为 | 规避动作 |
|---|---|---|
| 空串不是缺失 | 「值非空」类期望会放行空字符串——空串是一个值而不是缺失值;但索引期恰恰不允许空串 | 这是最容易漏的一道缝:用行级期望或正则显式拦空串 |
| 比较会忽略空值 | 大于、小于、等于、不等于、正则匹配这类比较默认忽略空值,空值自动通过;取值集合检查则相反,遇到空值会失败 | 要查空值必须显式写非空检查;不要用「大于 0」间接表达「非空」 |
| 前条件拦的不是输入 | 前条件失败时中断的是本转换的输出,不是那个输入数据集本身 | 要保护某个输入,就在产出它的那个转换上挂后条件 |
| 改检查名等于重建 | 检查按名字唯一;改名等同于删旧建新,历史与监控配置一起丢 | 检查名一旦定了当 API 契约对待,需要改名就新建并保留旧的过渡 |
| 增量也按全量跑 | 所有检查都在完整数据集上执行,与转换是否增量无关 | 这解释了「增量构建为什么报主键重复」:一次交易内不能有重复主键,要在管道里先去重 |
| 时间检查存在问题 | 日期类型不支持时间类期望;用「当前时间」派生的静态时间戳会无警告地给出错误结果;相对偏移只支持正向、精度只到分钟 | 新鲜度判断用官方相对偏移能力,或改成体量/状态类检查 |
引用完整性检查慎用
跨数据集的外键类期望官方标注为实验特性,且因为涉及连接求值非常昂贵。 要做引用完整性,优先用管道内的显式校验或物化一张对照表。
三个长期指标
- 准入拦截率:过低=检查形同虚设,过高=源头失控
- 隔离区积压与老化:没人修的直接证据
- 因数据导致的动作失败率:最贴业务痛感
责任怎么分
平台负责发现、度量、拦截、可视化;源系统负责人负责修;业务审批人决定哪些可带病上线、哪些必须挡。 三方写进同一份文档——因为官方已经声明质量与准确性不在平台默认保障范围内。
常见问题速查:六类,每条都有明确规避动作
与难点不同,常见问题是「知道就不会踩」的。这一页适合当代码与模型评审的固定检查项。
| 现象 | 根因 → 规避 |
|---|---|
| 同一对象出现两条 | 主键非确定性 → 主键必须由稳定业务键或确定性算法生成 |
| 对象类型属性一半是空 | 上帝对象 → 拆成具体类型 + 接口 |
| 改了数据源界面不变 | 以为写数据集就能查 → 必须经索引管道,且要接受延迟 |
| 索引一直失败重试 | 数据不合规被严格校验挡下 → 修数据而不是重试 |
| 手动编辑隔天消失 | 整表替换管道覆盖 → 编辑多的类型改用增量管道 |
| 动作重复生效 | 至少一次语义 + 无幂等键 → 外部副作用必须带幂等键 |
| 现象 | 根因 → 规避 |
|---|---|
| 函数改了数据但没生效 | 函数产生的编辑须经动作提交 → 用动作承载 |
| 动作里查不到自己刚写的值 | 批量写与读取时序 → 按最严隔离级别设计互斥判断 |
| 撤销后外部系统没撤回 | 副作用不在事务内 → 通知类副作用要可补偿或标注不可撤回 |
| 越权看到不该看的列 | 把读时策略当导出保护 → 导出、物化、下载单独管控 |
| 受限凭证放开更多数据 | 权限规则用了否定条件 → 一律写正向白名单 |
| 智能体答非所问 | 工具太多、描述含糊 → 合并同类工具,描述写「何时不该用」 |
| 换客户端就绕过管控 | 校验做在应用层 → 校验做在动作与策略层 |
| 密级没传到衍生产物 | 密级不自动传播 → 导出与物化时显式重挂密级 |
| 保存成功但对象类型变空 | 必填属性在数据里有空值 → 索引期才失败;先修数据再开必填 |
| 「非空」检查通过仍有空值 | 空串是一个值 → 用行级期望或正则显式拦 |
| 增量构建报主键重复 | 检查按全量跑且一次交易内不得重复主键 → 管道内先按窗口去重 |
治理类的两条影响最大
类型负责人离职后无人认领变更;以及为了「安全」而复制对象类型——前者让平台腐烂,后者让权限失控。
为什么常见问题值得单独一页
它们的共同特征是:发生时有明确信号,但没人知道那是信号。把规避动作写进评审清单,成本几乎为零。
怎么用这页
每次评审挑三行问「我们有没有」;半年下来这一页会变成你们团队的私有清单,比任何通用规范都管用。
最容易被低估的难点:本体是组织问题,不是技术问题
技术上的难点都有解法;组织上的含糊会把所有难点放大十倍,并且表现为「平台不好用」。
① 谁拥有类型
每个对象类型必须有一个具名负责人与一个业务审批人。 没有负责人的类型不允许进入生产;负责人变动要走交接,否则半年后没人敢改。
② 术语谁定
「客户」「设备」「完成」在不同部门含义不同。建一份可查询的术语表(它本身就是共享属性与接口的定义来源), 冲突时由业务审批人裁决并留痕,而不是由建模者挑一个顺眼的。
③ 变更怎么提
模式变更走分支与提案:改动方提,受影响方评审,评审记录与变更绑定。 没有这一步,两个团队会在同一批对象上互相覆盖。
④ 需求怎么挡
最常见的失败不是做不出来,是什么都答应:三个月后类型数翻五倍、每个都用不上。 用「无动作 / 无权威源 / 无负责人 / 无度量」四条硬标准挡在门外。
⑤ 谁为数据质量买单
质量问题发生在源系统,暴露在本体里,被业务方算在平台头上。 必须事先约定:平台负责发现与度量,源系统负责人负责修,双方共同定准入闸门的位置。
⑥ 怎么证明有价值
从第一天起留四个数:活跃用户数、被真实业务使用的对象类型占比、经动作提交的业务变更数、 这些变更对应的金额或时长。缺这四个数,第二年预算会很难谈。
组织信号 → 平台症状 对照
- 没有具名负责人 → 类型重复、命名混乱
- 术语没裁决 → 同一指标多处不一致
- 变更无评审 → 上线后互相覆盖、回滚频繁
- 质量无归属 → 平台背锅,源系统不动
最小可行治理
三件事就够起步:一张负责人表、一份术语表、一条「模式变更必须评审」的规矩。 别一上来建委员会——治理结构过重,团队会绕过它。
九步方法论:每步的完成定义与长期指标
把前面所有判据压成一条流水线。关键在完成定义——没有它,「做完了」永远是主观判断。
| 步 | 动作 | 完成定义(做不到就别进下一步) | 长期跟踪指标 |
|---|---|---|---|
| 1 | 锁定决策 | 一条决策写清五问:谁决策 / 看什么 / 动什么 / 谁能动 / 留什么痕 | 决策闭环数量 |
| 2 | 定身份 | 每个类型主键评审通过且标注「不会变」;标题键可读 | 主键变更次数(应为 0) |
| 3 | 定权威源 | 每个属性有唯一权威源与合并顺序;空值语义写清 | 多源冲突工单数 |
| 4 | 建对象与关系 | 反模式自查通过;每条关系标注基数与扇出预算 | 类型数 / 被使用类型占比 |
| 5 | 通管道 | 端到端可查;索引延迟有实测值并配监控 | 源到可查延迟、索引失败率 |
| 6 | 过质量闸门 | 准入校验上线;不达标数据进隔离区而不是静默丢弃 | 质量分、隔离区积压量 |
| 7 | 加动作 | 每个动作有参数校验、提交条件、失败提示、幂等键、撤销方案 | 动作成功率、撤销率 |
| 8 | 上权限 | 用真实用户跑完行列级用例;导出与物化单独管控 | 越权事件数(应为 0) |
| 9 | 验证与接智能体 | 任务型演练通过;工具集收敛;评测集有基线分数 | 人/AI 各自成功率差、引用准确率 |
顺序比内容重要
1–3 是「不可逆项」,必须最先做完;4–6 是「能不能用」;7–9 是「敢不敢交给别人」。 跳过 1–3 直接做 4 之后的项目,最后都会回去补。
把这页当验收单
九个「完成定义」直接抄进合同或内部里程碑。它们都是可判定的,不含「基本可用」「大致准确」这类词。
四个数长期看
索引延迟、质量分、动作成功率、被真实使用的类型占比。 这四个数同时变好,平台才在变好;其它指标大多是噪音。
运维与演进:避免本体在使用中退化
交付不是终点。缺少归属、服务水平目标与变更纪律,本体三年后必然退化为无人敢信的死系统;随之而来的是无边界的技术支持。
变脏的五个可观测信号
- 实体重复率:同一客户或供应商出现多条主记录。
- 孤儿对象比例:链接断裂、父对象已删除的记录。
- 口径漂移:同名属性在不同管道里有两套算法。
- 索引新鲜度:源系统变更到可查对象的延迟。
- 旁路写入量:绕过动作入口直接改库的次数。
三条机制
- 归属:每个对象类型有具名负责人与所属决策域,变更须其签字。
- 服务水平:按类型分级设定新鲜度、完整度与查询延迟目标,并纳入值班。
- 变更纪律:模式变更走分支与差异评审;可逆变更自动回滚,不可逆变更必须先写迁移。
避免落入交付后服务的泥沼
- 把支持做成产品:明确值班边界与响应时限,按决策域而非按数据表划分责任人。
- 把重复工单转成规则:同一类问题出现三次,就写成校验、闸门或自动修复。
- 每季度做一次减法评审:删除无人使用的类型与属性,比新增更能控制腐化速度。
- 用工程量而非热情支撑:将重复性运维工时控制在总工时的一半以内(Google SRE 的 toil 原则)。
智能体应用层:把本体交给 AI
本体的价值在 AI 时代被放大:模型不再需要猜 schema,只能在你定义的对象与动作里活动。 这一部分讲运行时、工具契约、沙箱、评测和外部接入。
Agent 骨架:会话 / 上下文项 / 事件 / 状态迁移
智能体不是提示词,是一台有状态机。四个概念把它变成可观测、可回放、可审计的工程对象。
| 概念 | 工程含义 | 没有它会怎样 |
|---|---|---|
| 会话 | 任务边界 + 归属 + 保留期 | 无法定位「哪次跑错」 |
| 上下文项 | 带来源/权限的最小单元 | 越权内容混入窗口 |
| 事件 | 不可变执行记录 | 只能靠日志猜 |
| 状态迁移 | 显式阶段与闸门 | 模型一路跑到写操作 |
自建平台要点
这四样要落在数据库里,不是内存变量。会话表 + 事件表 + 上下文表是智能体平台最值钱的三张表: 评测集从它们生成,成本归因靠它们计算,事故复盘用它们回放。
面向业务的智能体装配:检索上下文 + 工具 + 应用状态 + 引用
低代码智能体构建器(Chatbot Studio,原名 Agent Studio)的四个配置面,正好对应本体平台的四种能力。
① 检索上下文:三种来源
- 本体支撑:对象/对象集,检索到的是可继续操作的业务实体。
- 文档支撑:分片 + 向量,用于手册、政策、合同。
- 函数支撑:把实时计算结果作为上下文注入(动态、非静态语料)。
一旦配置了检索,相关消息就会走检索链路;未配置则没有引用可给。
② 工具:动作 / 函数 / 检索
把本体能力暴露给模型。两种调用模式:提示式(在提示词里约定调用格式,兼容性好、可控性强) 与 原生工具调用(依赖模型能力,稳定但受模型可用性约束)。跨模型迁移时这一项最容易坏。
③ 应用状态
读取当前应用的筛选、选中对象、页面上下文, 使「解释我选中的这一条」成为可能,而不需要用户复述。
④ 引用与上下文窗口
回答必须能指向来源对象;上下文窗口是硬预算,塞太多对象会让关键关系被挤出。 设计时按「一次问答最多需要多少个对象」来配。
| 交付面 | 要点 | 常见遗漏 |
|---|---|---|
| 发布 | 作为应用发布给指定人群,权限沿用本体与动作定义 | 把智能体当独立权限体系另建一套 |
| API 调用 | 可被外部系统以会话方式调用 | 没设会话归属,事后无法追责 |
| 命令 / 快捷入口 | 把常用意图固化成按钮,降低模型自由度 | 全靠自由输入,质量方差大 |
| 日志 | 对话与工具调用留痕,供评测与审计复用 | 日志权限未隔离,敏感问答被过度可见 |
工具设计准则:让模型只会按按钮,不会自己写 SQL
工具是给模型用的 API。它的质量决定智能体的上限——描述不清、参数过宽、无确认,就会出现「模型很自信地做错事」。
七条硬准则
- 一个工具一个意图,禁止可选参数堆砌。
- 描述写「什么时候该用」,而不只是「做什么」。
- 参数用枚举/引用对象 ID,不给自由文本。
- 返回量设上限,附带可继续遍历的句柄。
- 写类工具必须声明副作用与确认要求。
- 幂等键必填,重试不能重复生效。
- 失败返回可读原因,让模型能自我纠正。
{
  "name": "submit_discount_plan",
  "description": "当批次库龄>90天且毛利低于阈值时使用;
                一次只处理一个批次。不要用于询价。",
  "input_schema": { "batchId":{"type":"string"},
                     "discountPct":{"type":"number","max":30} },
  "permission": { "action":"submit_discount_plan", "scope":"inventory" },
  "side_effects": ["ontology_edit", "notification", "wms_writeback"],
  "requires_confirmation": true,
  "idempotency": "required",
  "timeout_ms": 30000
}| 工具类别 | 风险 | 控制手段 |
|---|---|---|
| 只读检索 | 越权可见、结果过大 | 权限读时过滤 + 返回上限 |
| 计算/预测 | 超时、成本失控 | 限额 + 缓存 + 明确 SLA |
| 写动作 | 错误业务变更 | 确认 + 幂等 + 提交条件 + 可撤销 |
| 外部调用 | 不可撤回的副作用 | 默认禁用,白名单逐个开 |
反例:一个 update_object(type, id, json) 工具把整个本体交给模型——参数空间无限、无法审计、无法测试。这不是工具,是后门。
六层沙箱:智能体在哪里跑,出了事能圈多大
「沙箱」不是一个容器,而是六层独立边界。任何一层缺失,事故半径就会扩散到全平台。
| 层 | 隔离什么 | Palantir 已文档化的做法 | 自建时必须自己回答的问题 |
|---|---|---|---|
| 运行时 | 代码执行环境 | 函数与计算模块在受管运行时执行,有强制资源与时长上限 | 能否防止逃逸 / 是否禁网 / 依赖从哪来 |
| 权限 | 身份与授权 | 以调用者或自动化 owner 身份执行;资源 + 数据 + 动作三轴 | 服务账号如何避免成为超权捷径 |
| 数据 | 可见范围 | 读时策略过滤、受限视图、密级;检索结果天然带权限 | 缓存与向量索引是否会绕开策略 |
| 状态 | 写入影响面 | 情景(scenario)副本推演;动作事务与撤销;分阶段写 | 试算与生产如何物理区隔 |
| 工具 | 可调用集合 | 动作/函数需显式配置为工具;写工具受提交条件约束 | 白名单粒度是否到「单个工具 × 单个角色」 |
| 测试 | 变更前的爆炸半径 | AIP Evals 套件 + 本体模拟;分支工作流 | 有没有「跑不过评测就不许发布」的硬门 |
外部 Agent 接入的额外边界
凭证作用域、可访问工具集、速率限制、数据出口(egress)审计。 构建型 MCP 与消费型 MCP 的能力面本就不同,不要混用凭证。
威胁模型四问
- 提示注入能拿到什么?
- 越权工具调用能否被拦截?
- 数据能否经外部模型泄漏?
- 事故能否回滚 + 定位到人?
MVP 三件事
先做工具白名单、写操作确认、全量事件留痕。 这三项覆盖绝大多数事故来源,成本远低于运行时隔离。
没有评测与可观测,AI 就是不可发布的功能
智能体的质量是统计量,不是印象。评测套件负责「上线前敢不敢」,可观测负责「上线后知不知道」。
评测 AIP Evals
- 套件:问题 + 期望;可从真实会话沉淀。
- 评审器:规则、字符串指标(如 ROUGE)、以及 LLM-as-judge。
- 迭代次数 ≥3:单次通过没有意义,要看分布。
- 并行度(示例量级 10)与 作用域:用户级 or 项目级共享。
- 本体模拟:在副本上跑写操作评测,不影响生产。
可观测 Observability
- 指标:调用量、延迟、失败率、token 与成本。
- 运行史(保留期示例约 30 天)与 trace:看清单次执行链。
- 日志本身也受权限约束——密级不会被自动传播到衍生产物。
- 模型容量:TPM/RPM 分层(租户 / 项目 / 用户),交互流量有预留比例, 批量任务可占用保留容量。
| 要回答的问题 | 需要的数据 | 没有的后果 |
|---|---|---|
| 新版本比旧版本好吗? | 同一评测套件的分布对比 | 凭感觉发布,回退无依据 |
| 哪类问题总答错? | 失败样本按意图聚类 | 优化打在空气上 |
| 谁在用、用在什么对象上? | 会话 + 上下文项归属 | 无法证明 ROI,续约谈判被动 |
| 一次事故影响哪些决策? | 动作日志 + 决策血缘 | 合规事件无法定量 |
| 成本花在哪? | 按项目/用户/工具的 token 归因 | 容量与预算互相甩锅 |
落地顺序建议:先做事件留痕 → 再做运行看板 → 再从真实失败沉淀评测集 → 最后把评测设为发布硬门。
外部 Agent 与 IDE 怎么接进来:四条路
「让 ChatGPT / Claude / 自研 Agent 用我们的本体」在 Palantir 体系里是四条不同的路,能力面、身份模型和适用场景都不一样。
| 路径 | 面向 | 能做什么 | 不能做什么 / 约束 |
|---|---|---|---|
| Palantir MCP | 构建者(在编码工具里搭本体) | 读本体结构、生成 OSDK / 应用代码、提出变更提案供人评审 | 默认不开放本地 MCP;不写业务数据;破坏性变更走提案评审 |
| Ontology MCP(OMCP) | 消费者(外部 Agent 使用本体) | 把 Developer Console 应用作为 MCP 服务端暴露;OAuth 授权码或客户端凭证;应用级限制与 scope | 只暴露 tools,不提供 prompts / resources |
| LLM 兼容代理端点 | 模型接入 | Anthropic / OpenAI / Google / xAI 风格端点,Bearer 平台令牌;数据留在平台侧 | 受零数据保留、地域限制等策略约束 |
| OSDK / 平台 API / 自定义端点 | 自研应用与服务 | 类型化客户端、批处理、把函数发布成 HTTP 端点给任意 Agent 调用 | 需要自己实现 Agent 运行时与治理 |
# 构建侧:把 Palantir MCP 挂进编码 Agent(以 Claude Code 为例)
export FOUNDRY_HOST="<your-foundry-hostname>"
export FOUNDRY_TOKEN=<token>   # 在 Foundry 仓库内可省略,用 Git token 引导
claude mcp add palantir-mcp --scope project \
  -e FOUNDRY_TOKEN='${FOUNDRY_TOKEN}' \
  -- npx "-y" "palantir-mcp" \
     "--foundry-api-url" "https://$FOUNDRY_HOST"
{
"mcpServers": {
"my-ontology": {
"type": "http",
"url": "<ontology-mcp-server-url>",
"headers": {
"Authorization": "Bearer ${env:FOUNDRY_TOKEN}",
"Accept": "application/json, text/event-stream"
}
}
}
}结论口径:凡是支持 MCP 的客户端(Claude 系、Codex / ChatGPT 桌面、Cursor、Continue 等)理论上都能走上述路径; 官方明确列出的支持范围会变动,接生产前要在自己环境实测一次工具发现与写操作边界。
Onyx Incorporated:官方虚构公司,一条完整决策闭环
Palantir 在文档里用一家虚构的医疗设备制造商 Onyx 演示「决策中心本体」。 剧情:主要供应商中断 → 关键原材料短缺 → 外科口罩需求上升 → 生产排期吃紧 → 大量客户订单受影响。
为什么用它做教学案例
它不是「做个聊天机器人」,而是用 AI FDE 把广泛的数据源、逻辑资产、动作系统接进企业本体—— 正好覆盖本稿前两部分的全部内容,且官方给了五张架构图与逐步叙事。
公司设定
- 医疗设备 / 医疗产品制造商 + 分销商(注射器、外科口罩等)
- 靠并购成长 → 系统异构:WMS + 三套 ERP + 生产计划系统 + 边缘设备
- 业务面:供应商、仓库、工厂、配送中心、客户履约
- 核心工作流:订单履约、维护任务分配
演示纪律
Onyx 不是真实客户,其数字不可当业绩引用;官方也没有公开它的数据集与 schema。 可复用的只是设计思路与图。
| 页面 | 对应层 | 看什么 |
|---|---|---|
| 总图 | 全景 | 三个消费面 / 三组供给 / 本体 / 安全治理底座 |
| 数据 | 语义层 | 对象与链接,以及「决策数据」也被建模 |
| 逻辑 | 动能·逻辑 | 模型成为可调用决策节点 + 情景沙箱 |
| 动作 | 动能·动作 | Agent 提议 → 人审 → 写回多系统 |
| 学习 | 动态层 | 决策血缘变成下一轮训练数据 |
总图:本体是中间那一块,上下都是它的朋友
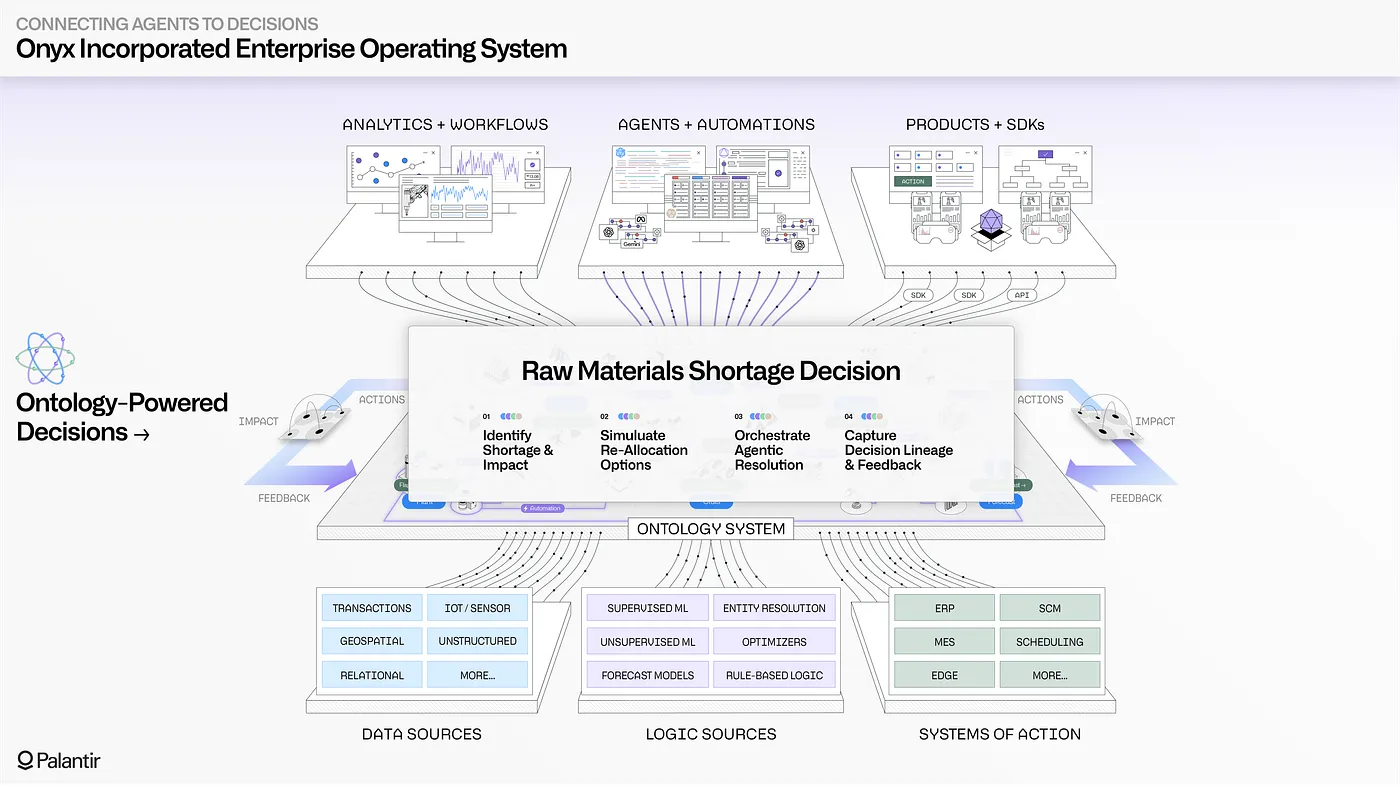
这张图就是「四位一体」
数据 / 逻辑 / 动作 / 安全四合一的可视化。任何自建平台的架构图,都应该能被这张图的六个区块逐一对应; 对不上,说明有面缺了。
三个消费面 = 三种交付形态
分析工作流、智能体、以及被产品化/SDK 化的对外接口。同一本体,三种用法,不必各建一套数据。
Systems of Action 是关键术语
本体不只是被读,它要能驱动下游执行系统。没有这一组,项目就止步于「看得见」。 Onyx 的下游包括 WMS、三套 ERP、生产计划系统。
数据层:把五个系统变成八个对象类型
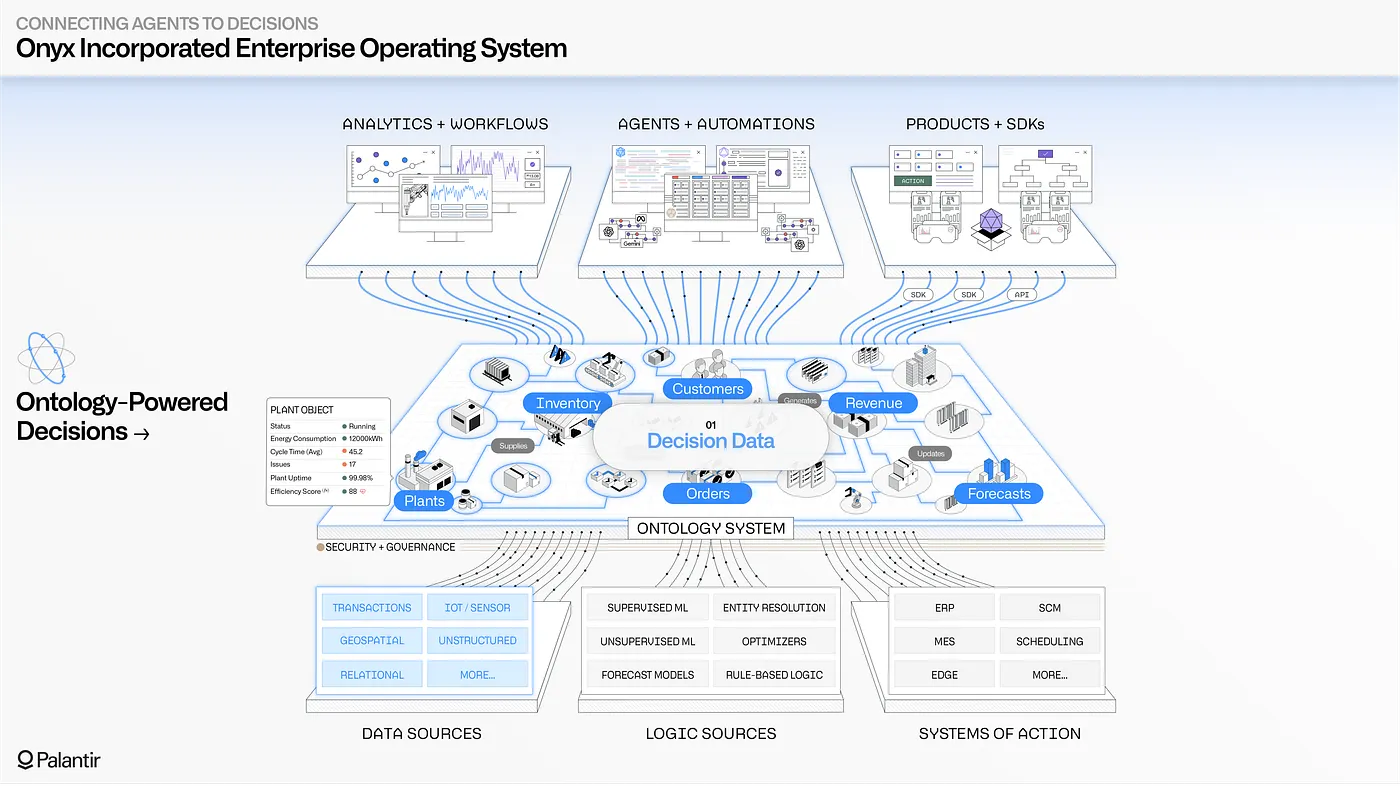
Plant Object 示例属性
Status · EnergyConsumption 12000kWh · CycleTime 45.2 · Issues 17 · PlantUptime 99.98% · EfficiencyScore 88
三个可借鉴点
- 对象数量克制:8 个类型撑起一条完整链路,不是 80 个。
- 导航即分析:从「口罩生产风险」一路跳到受影响客户订单,靠的是链接而不是新查询。
- 决策也建模:Decision Data 让「谁在什么上下文做了什么决定」可查询。
安全随范围变化
财务等敏感字段默认隐藏,响应范围扩大时自动控制可见性——权限不是开关,是随上下文变化的函数。
逻辑层:模型不是 prompt 里的文字,是可调用节点
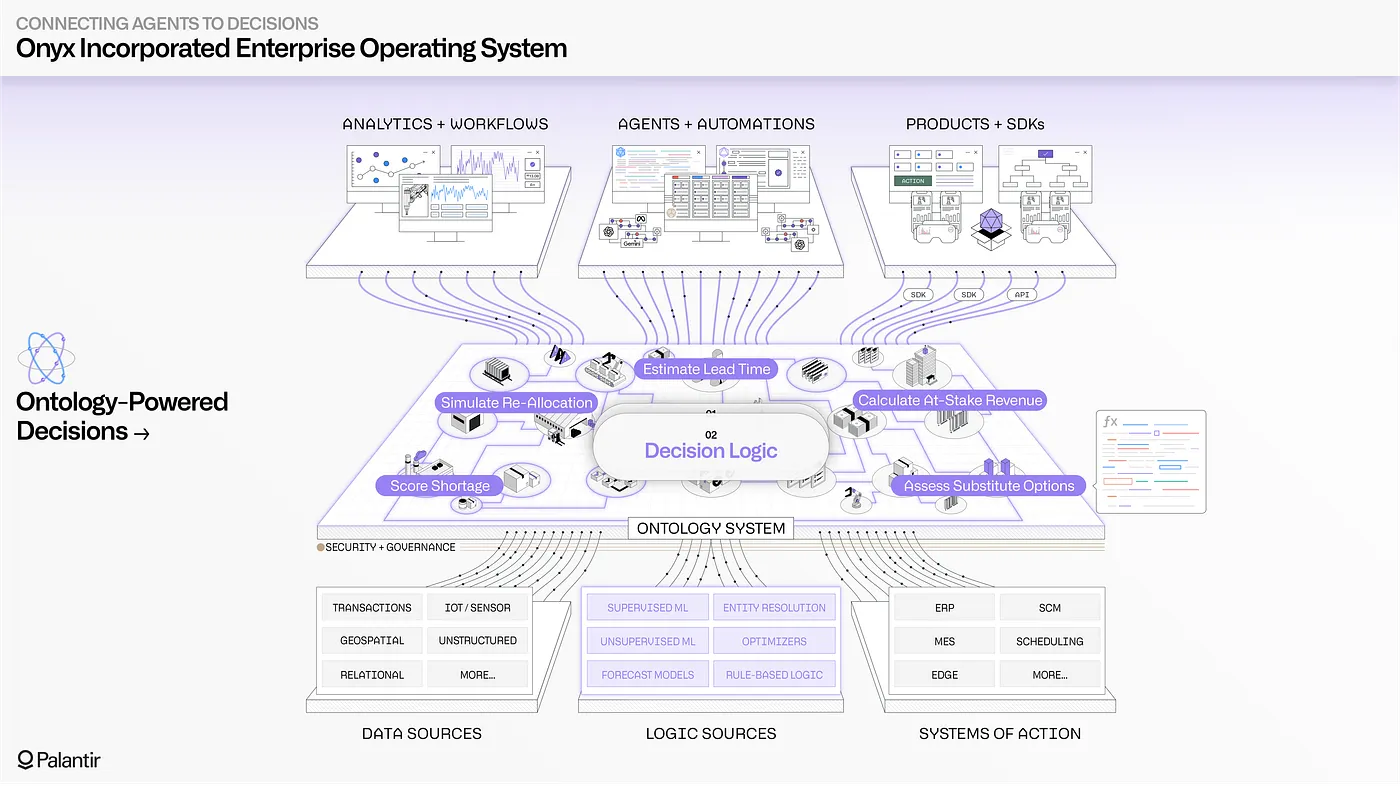
与「文档问答」的分水岭
普通 RAG 助手把规则写在提示词里;Onyx 把预测模型、分配模型、生产优化器接进本体, 成为可组合的计算资产。人用的和 Agent 用的是同一套。
Scenario = 隔离沙箱
模拟结果放进本体情景,不直接改生产数据。分析师可以快速跑多组替代物料方案而不担心污染。
节点命名法
动词 + 业务名词(Estimate / Simulate / Calculate / Score / Assess)。 这套命名直接可当 LLM 工具名,无需二次映射。
可迁移做法:把「算一下」类逻辑做成 5 个以内的小节点,而不是 1 个大引擎。小节点可组合、可评测、可被 Agent 精确调用。
动作层:Disruption Bot 提议,人类审核,写回 WMS / 三套 ERP / 排程
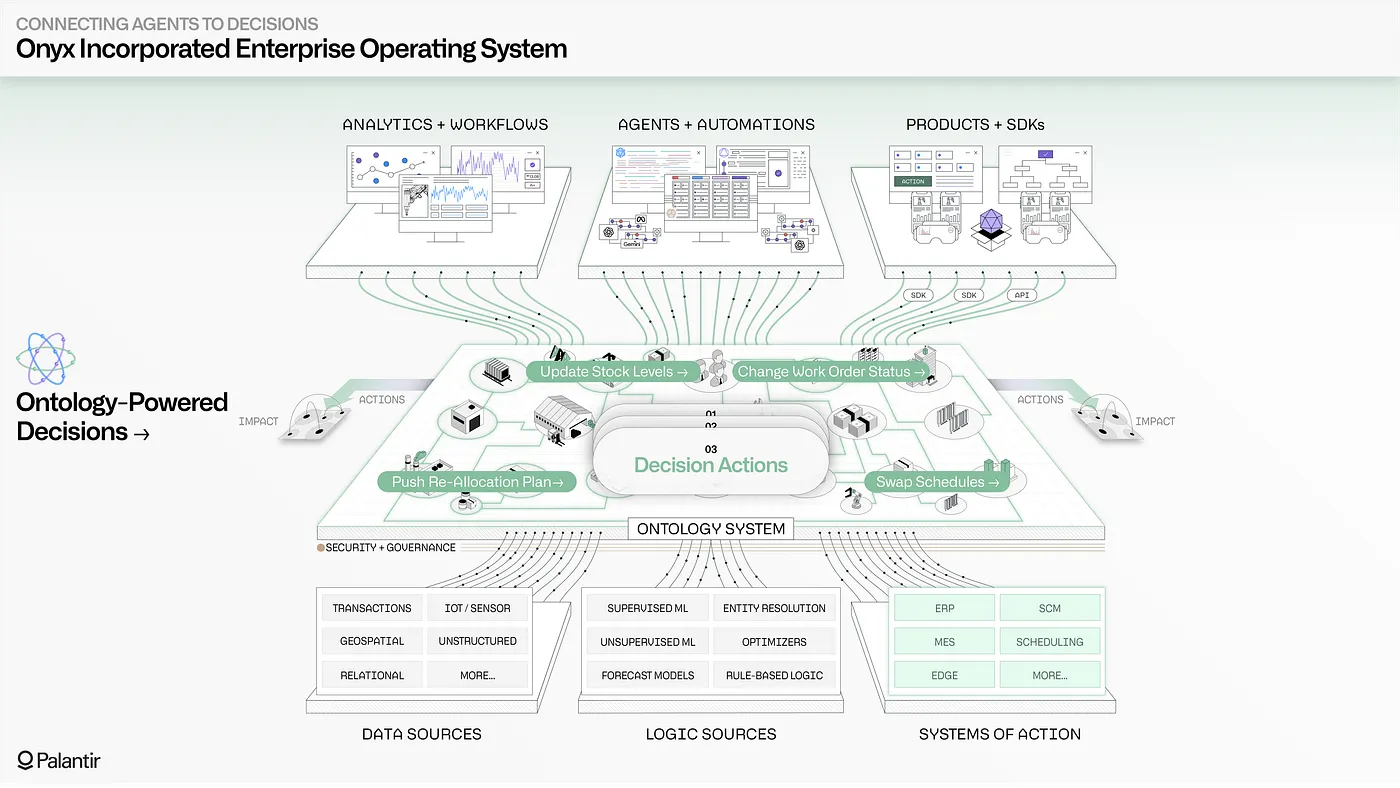
| 下游系统 | 写回方式 |
|---|---|
| WMS | API 更新 |
| 三套 ERP | 原生本体连接器,遵守各系统安全约束 |
| 生产计划系统 | 合并 flat file,异步导入 |
四条控制机制
- AI 默认只能 staged 动作,人审后才提交。
- 只有充分测试、可信的流程才允许自动闭环。
- 所有动作有精细日志与审计。
- Agent 权限随信任逐步调节,即时反映到所有本体工作流。
剧情细节
Disruption Bot 扫描本体数据、历史行动的事后报告与可用再分配模型, 找到了分析师没考虑到的新方案(用了较新模型)——然后交人审核。这就是 human-AI teaming 的落地形态。
「自动化程度像拨盘而不是开关」是官方叙事里最好的一句产品哲学:同一套动作定义,可以按信任度调节自动提交的门槛。
学习层:决策血缘成为训练数据
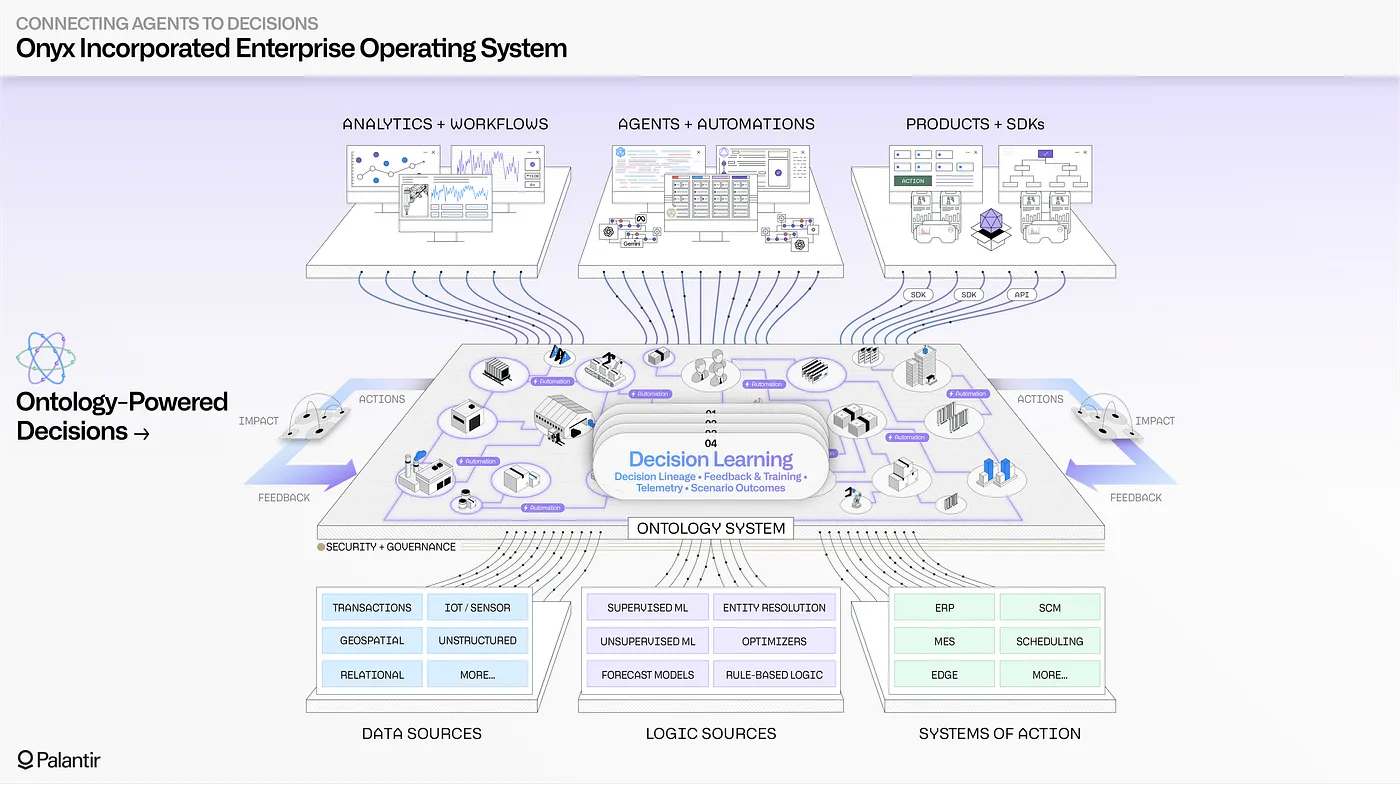
与数据目录 / 语义层的根本区别
它把决策本身变成可学习的数据:每个数据元素、每个逻辑资产、每次动作评估都被捕获成端到端血缘。
血缘的三种下游用法
- 作为微调模型的训练语料
- 提炼成 Agent 提示词里的原则
- 作为审计与事故复盘的证据链
自建时怎么起步
最小血缘记录五元组:(who, when, inputs_snapshot, chosen_option, outcome_metric)。 先记下来,后面才有东西可学。
四步闭环回看
识别(数据)→ 模拟(逻辑 + 情景)→ 编排(动作 + Agent)→ 捕获(血缘)。 这是本稿第二部分三层结构在本案例中的投影。
Titan 实操一:从原始数据集到可查对象(Data Tools)
「Building with Palantir AIP」系列的第一集,演示同一条链路的工程实现细节:接入、健康、分支、安全、逻辑与调试。
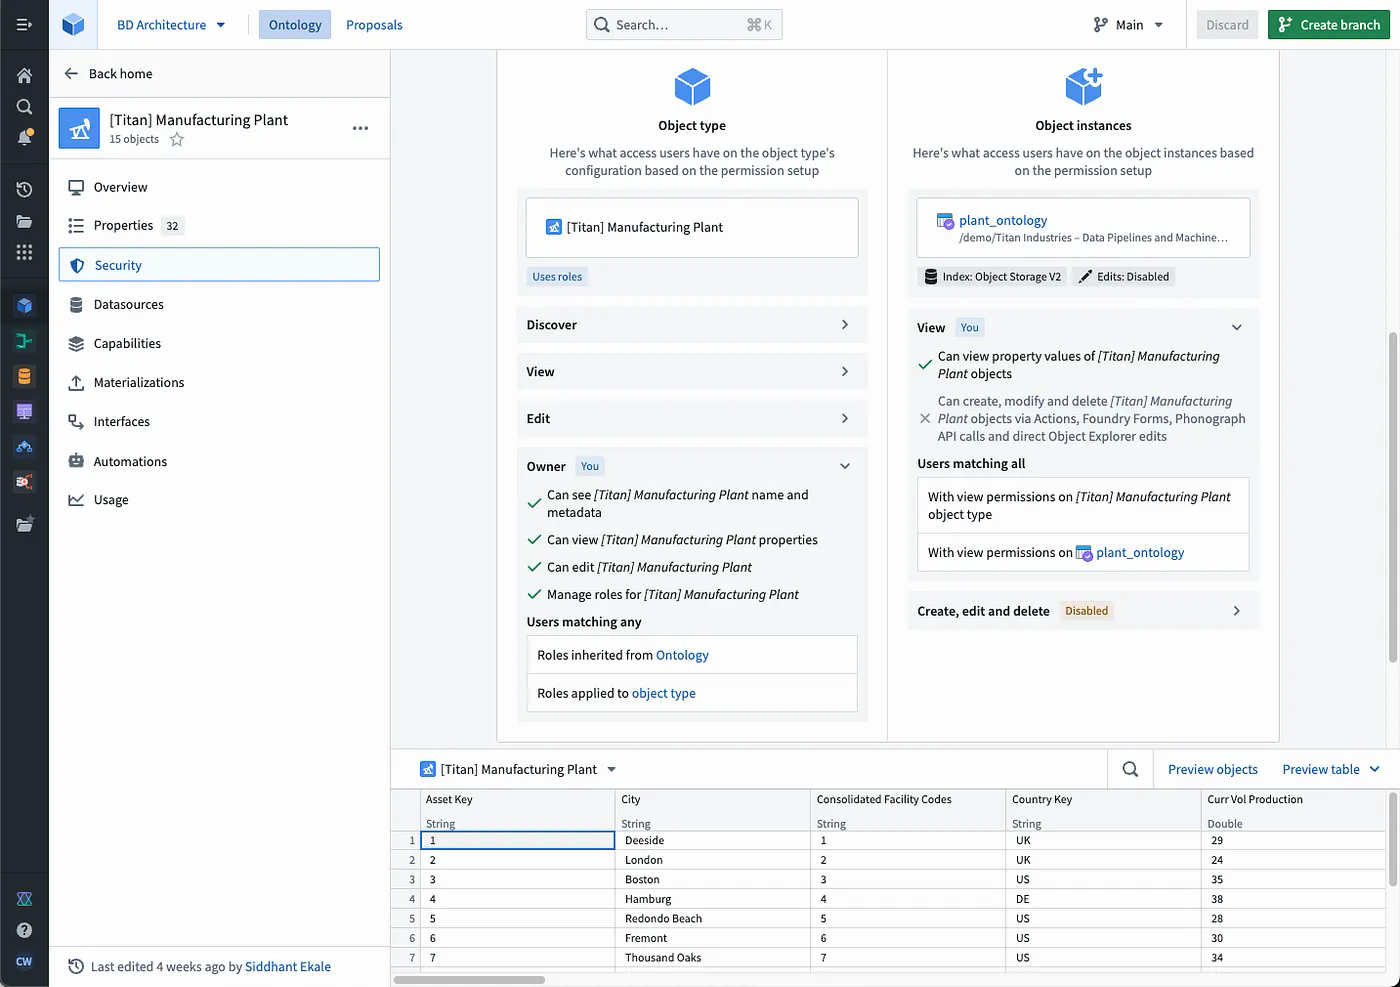
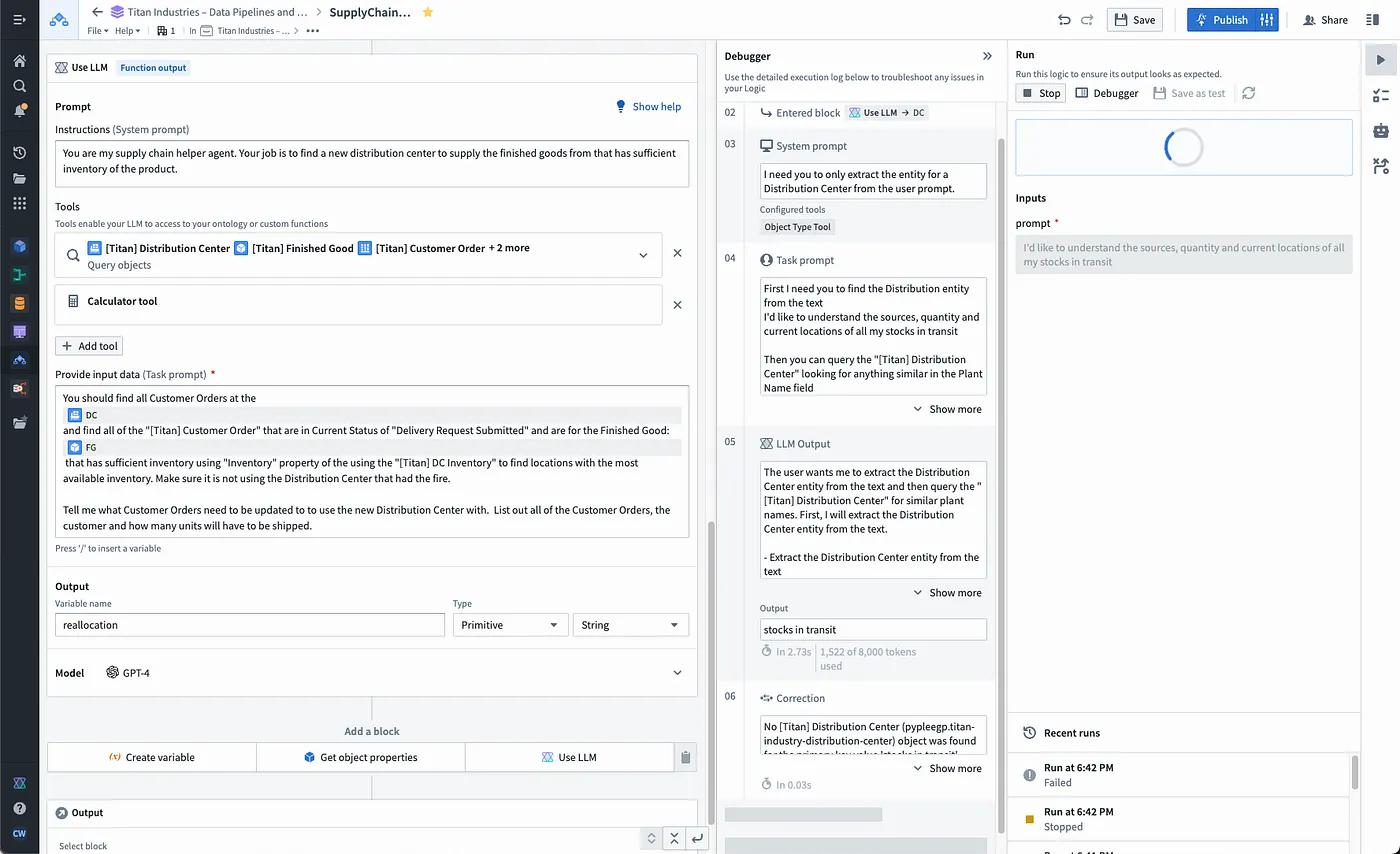
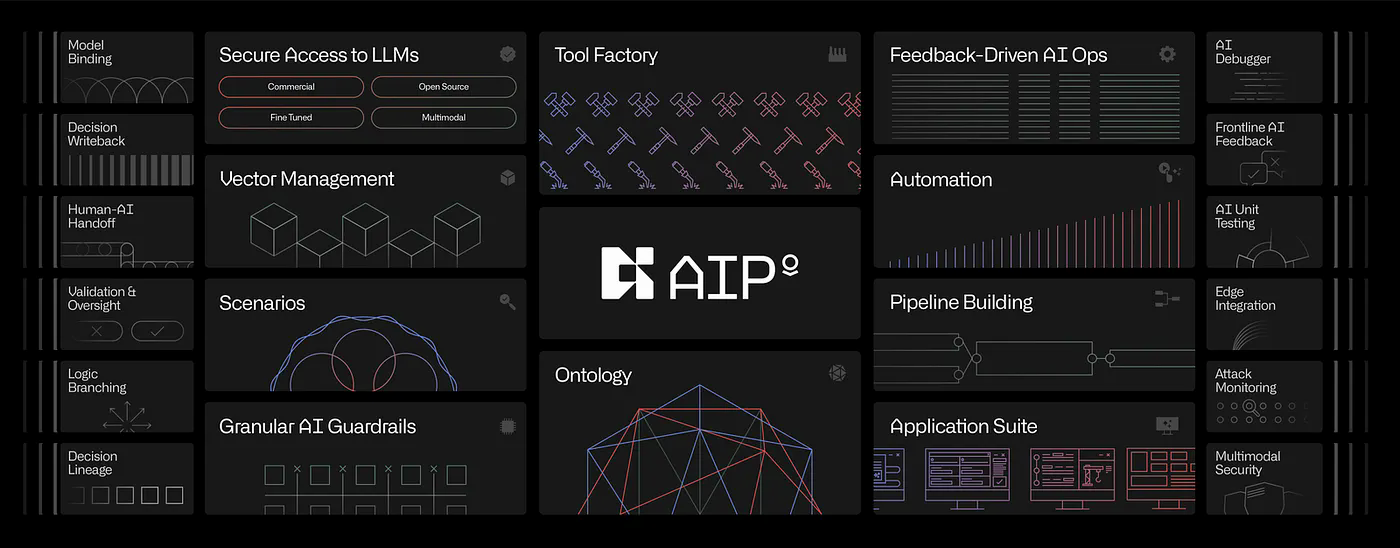

- 接入即建血缘,不用手工维护数据字典。
- 健康检查建成对象,责任人可被自动路由。
- 管道与本体改动走分支,diff 后再合并。
- 安全配置在建模界面里可见可改,不藏在后台。
- 逻辑编排提供调试器,块级输入输出可看。
- 应用层直接用对象集,不额外做一套查询 API。
Titan 实操二/三:RAG → OAG 的实证,与过程挖掘
- 同一套工具,人与 Agent 共用——避免出现「人用的逻辑」和「AI 用的逻辑」两套真相。
- Modeling Objective:一次训练 27 个模型变体,固定评估子集比较,配评审关卡,暂存 → 生产。
- 预测即工具:Prophet 需求预测注册为逻辑工具,LLM 在推理中按需调用而非预先算好。
- 供应链 co-pilot:AIP Logic 把检索、计算、动作串成一条可解释流程。
- 范式:过程对象 + 日志对象(见第 26 页代码),零流程引擎依赖。
- 产出:真实流程图、瓶颈耗时、返工率、例外路径,全部是可查询对象。
- 与 MRO 设备场景结合:机器状态迁移历史直接暴露「谁在绕过流程」。
- 信用挂单案例给出「规则 + 例外 + 审批」三件套的完整建模样例。
Onyx 与 Titan 是同一「虚构医疗用品公司」演示谱系的两个命名:Onyx 用于产品文档(why-ontology),Titan 用于 Building with AIP 博客与视频系列。教学上取前者讲架构、取后者讲实操。
Top 10 常见问题与硬限制:把「以后会出问题」写成今天的约束
本体的常见问题高度集中:身份、写路径、索引、权限、限额五类。提前知道数值,比事后重构便宜一个数量级。
| # | 问题 | 为什么代价高 |
|---|---|---|
| 1 | 主键会变 | 对象身份断裂,历史动作与外部引用全废 |
| 2 | 没有唯一写入入口(允许旁路 CRUD) | 审计与权限同时失效 |
| 3 | 把清洗逻辑放进派生属性 | 索引成本转移到每次查询,规模上升后失效 |
| 4 | 多源无裁决规则就上 | 同对象多版本、null 抹掉有效值 |
| 5 | 权限事后补 | 只能做到粗粒度,敏感列已扩散 |
| 6 | NOT 条件 + 受限凭证 | 可能反转成放开数据 |
| 7 | 动作无幂等键 | 至少一次语义下重复副作用 |
| 8 | 从不测索引延迟 | 业务看到「旧数据」,从此不信任平台 |
| 9 | 工具数量过多 | LLM 选错工具率上升,评测也救不回 |
| 10 | 把 LLM 当确定性组件 | 无评测/无回退,非确定性无法管理 |
| 类别 | 需要实测确认的量级 |
|---|---|
| 本体 | 单类型属性数上限、对象总量、链接基数、类型分组数 |
| 动作 | 单次编辑对象数、参数数、批量大小、Webhook 超时 |
| 函数 | 执行时长、内存、并发、返回值体积 |
| 查询 | 结果集阈值(下推 / 内存 / Spark 边界)、遍历跳数 |
| 流式 | 每类型带宽、检查点间隔、允许的 schema 变更 |
| 自动化 | 规则数、触发频率、并发、失败重试与回退 |
| AIP | TPM/RPM、上下文窗口、向量维度上限、Logic 运行时长 |
官方文档口径存在冲突(务必实测)
- Search Around 规模:不同页给出 10 万 / 1000 万 / 3000 万三种说法
- Struct 属性在检索列上的支持:两页描述不一致
- 三层 vs 四位一体:两种叙事并存(见 P23 消歧)
- 旧对象存储的停用日期在文档中已过期,需按自己环境核实
使用方式:把这 10 条作为设计评审的固定检查项,把限额表作为容量规划输入。凡是「不知道数值」的项,都排一次实测。
自建平台:六面参考架构 + 十个必须早做的决策
| 决策 | 选项 | 本稿建议 |
|---|---|---|
| 元数据 vs schema-first | 运行时可改 vs 编译期强约束 | 类型 schema-first,属性值宽松;否则 OSDK 与工具契约无法生成 |
| 对象存储形态 | 索引 / 物化 / 直查源 | 默认索引,热点物化,直查源只给低频大表 |
| 写路径 | Action-only vs 允许 CRUD | Action-only,这是审计与权限成立的前提 |
| 一致性 | 快照 / 读已提交 / 串行化 | 默认快照,互斥判定用最严档 |
| 权限时机 | 查询时过滤 / 写入时固化 | 读时过滤为主,密级类在写入时固化 |
| 版本演进 | 分支提案 / 环境晋级 | 两者都要:建模走分支,发布走晋级 |
| 多租户切分 | Org / Space / Ontology | 先定「本体是否可跨租户」,再定隔离粒度 |
| 逻辑运行时隔离 | 进程内 / 容器 / WASM | 按不可信程度分级,默认容器 |
| Agent 是否独立平面 | 合入应用 / 独立 | 独立:会话、上下文预算、评测属于平台能力 |
| 对外形态 | SDK / OpenAPI / MCP | 三个都从同一份类型定义生成,不手写 |
路线图
| 阶段 | 目标 | 退出判据(做不到就别进下一阶段) |
|---|---|---|
| Phase 0 领域与身份 | 对象类型、主键、标题键、API name、命名纪律 | 业务方能读懂类型清单;主键经评审确认不变 |
| Phase 1 只读语义层 | 连接器 + 索引 + 查询 + 检索 + 血缘 | 一条链路端到端可查,索引延迟有实测数字 |
| Phase 2 写路径 | 动作运行时、事务、提交条件、日志、撤销 | 一个真实动作上线且被审计,重复提交不重复生效 |
| Phase 3 安全与演进 | 策略引擎、行/列权限、分支与迁移 | 能回答「谁能看这行这列」;破坏性变更有迁移路径 |
| Phase 4 逻辑与模型 | 函数运行时、模型网关、情景推演 | 模型输出落成属性或工具,且可复现 |
| Phase 5 Agent | 会话/上下文/工具注册/评测/trace/成本护栏 | 评测通过率有基线;写动作默认需确认 |
| Phase 6 生态与规模化 | SDK/OpenAPI/MCP 生成、市场、多租户、性能 | 外部团队能自助接入且不需要你改内核 |
不要照抄的七件事
- 旧对象存储的历史包袱(索引与查询要分离)
- 2000 属性宽表(按领域拆类型)
- 全部产品面(先做核心闭环)
- 复杂权限组合(先 RBAC + 行级)
- 「万能 Action」
- 把 LLM 当确定性组件
- 把 Agent 当超级用户
五条原则(按顺序执行)
- 身份先于数据
- 写路径先于 AI
- 权限先于共享
- 评测先于上线
- 闭环先于规模
最小可用(P0)长什么样
10 个对象类型 · 1 条管道 · 1 个只读应用 · 1 个动作 + 日志 · 行级权限 · 会话与事件留痕 · 一套 10 题评测。 两周内可演示,两个月内可投产。
现场视频:官方 AIPCon 6 宣传片
活动混剪,并非 Onyx 专属演示;完整直播需登录官方频道。
完整 Demo:把生产本体接到 WorkBuddy 上
前面所有页面讲「本体是什么、怎么建」;这一章讲「建好之后,一个真实的办公型 Agent 客户端怎么把它用起来」。 场景为虚构,配置形态取自双方官方文档。
场景:Corvina Medical · 信用挂单放行台
- 公司:Corvina Medical,虚构的医疗器械分销商,业务覆盖华东与华南,并购成长 → 三套 ERP + 一套 WMS + TAPD 工单
- 日常:日均 1200 单,约 180 单命中信用挂单
- 处理人:3 名信用专员,每人每天 4 小时逐单判断
- 一单五步:读销售邮件 → 在 ERP 查客户信用 → 在 Excel 算敞口 → 决定放行/拒绝/要求预付 → 回邮件并在共享文档记台账
- 代价:错放一单平均损失 12 万元;漏放一单压 200 万营收
为什么这个场景「非本体不可」
知识库能回答「信用政策怎么写」,回答不了「今天哪些单该放」—— 后者需要实时对象、跨系统关系、可执行动作与逐人权限四件同时成立。
| 角色 | 承担什么 |
|---|---|
| WorkBuddy(桌面 Agent) | 自然语言入口、企业微信/邮件/腾讯文档连接器、定时任务、资料库沉淀产物 |
| WorkBuddy 企业版 | 统一身份与授权管理、成员统计、智能体配置、私有化或专享 VPC 交付 |
| 本体平台(Palantir 式) | 客户 / 订单 / 挂单对象、信用敞口计算、放行动作、行级权限、动作日志 |
| OMCP 服务 | 把上面三样以标准 MCP 工具形式暴露给外部 Agent |
本章交付物
- 一张端到端架构图(P68)
- 本体侧资源与授权清单(P69)
- WorkBuddy 连接器配置与三种认证落法(P70、P71)
- 三幕可照演的演示脚本(P74–P76)
- 官方支持 vs 需自建的诚实清单(P76)
- 一页可复用配置卡(P78)
端到端架构:连接器只是管道,边界留在本体
为什么中间要放一个网关
WorkBuddy 的自定义连接器通常以静态请求头方式携带凭证;而本体侧的 MCP 服务用 OAuth 2.0。 网关负责跑授权码流程、把「当前桌面端用户」映射成「本体侧身份」,凭证就不落在员工机器上。
关键设计原则
不要在网关里做权限判断。网关只做身份转换与审计; 可见范围、可提交动作一律由本体的策略决定。否则你会得到第二套权限系统——两套都会失真。
两侧各自不可替代
WorkBuddy 提供的是「办公动作」:读邮件、发企微、写共享文档、跑定时任务。 本体提供的是「业务真相」:此刻哪些单挂着、敞口多少、谁能放行。缺任一侧,这条流程都跑不完。
本体侧准备:只暴露三个对象、两个动作、两个函数
接入范围越小,Agent 越准。这一步的产物是一张「资源清单」,它同时就是权限清单和测试清单。
| 暴露为 MCP 工具 | 形态 | 为什么必须给 |
|---|---|---|
| Customer | 对象(可读) | 信用额度、账期、逾期历史——判断的输入 |
| SalesOrder | 对象(可读) | 金额、承诺交期、关联客户 |
| CreditHold | 对象(可读) | 挂单本身建成对象,才谈得上「今天哪些单挂着」 |
| release_credit_hold | 动作(可写) | 唯一放行入口,带提交条件与日志 |
| request_prepayment | 动作(可写) | 第二种处置:要求预付后放行 |
| credit_exposure(customerId) | 查询函数 | 实时敞口,含在途订单;不让模型自己加总 |
| rank_held_orders() | 查询函数 | 按金额×逾期天数×客户等级排序,给出工作队列 |
刻意不暴露的东西
- 不暴露 Invoice 与付款明细——专员不需要,暴露就多一个泄露面。
- 不暴露「更新客户额度」动作——额度调整属财务独占,走另一条流程。
- 不暴露通用 update_object;一个动作只做一件事。
- 不暴露 Shipment——地图需要它在数据层,Agent 的问题里没有「这张运单到了没有」;加入它会破坏「恰好七个工具」的收敛。
动作定义里的三道闸
- 参数:挂单 ID、放行理由(枚举)、有效期(≤30 天)。
- 提交条件:放行后敞口 ≤ 额度 × 1.1,且理由非空,且提交人属信用组。
- 副作用:企微通知销售、写回 ERP、生成台账记录。
授权配置
应用级限制(application restrictions)+ scope 收到最小:只读上述三类型、只可调上述两动作; 行级范围由本体策略决定——专员只能看到自己负责区域的挂单。
验收方式:用官方 MCP Inspector 连一次,确认工具列表恰好是这七个、Prompts 为空;Resources 只允许出现一个 ui:// 界面资源(MCP Apps 面板用的 HTML,不含业务数据),任何客户 / 挂单 / 台账都不许从资源口出。
WorkBuddy 侧:一个自定义连接器 + 两个办公连接器
入口与形态
官方文档:连接器分 MCP + CLI 与 Skill + CLI 两种形态; 自定义连接器用于「安装自定义的 MCP 服务」,可在连接器管理页配置,也可写入用户级或项目级配置。
官方明确的权限原则
- 独立授权:每个连接器单独授权
- 不主动定时抓取,仅在指令触发时按需读取
- 不超出用户已有权限范围
- 写入类操作需明确指令确认
这四条与本体侧的设计天然对齐——所以本 demo 不需要在客户端另造一套护栏。
// 自定义连接器(示意):经网关接入生产本体
{
  "mcpServers": {
    "corvina-ontology": {
      "type": "http",
      "url": "https://mcp-gateway.intranet.corvina.com/ontology",
      "headers": {
        "Authorization": "Bearer ${env:CORVINA_MCP_TOKEN}",
        "Accept": "application/json, text/event-stream"
      }
    }
  }
}| 连接器 | 在本 demo 中的职责 | 授权粒度 |
|---|---|---|
| 本体连接器(自定义 MCP) | 查对象、算敞口、提交放行动作 | 由本体策略决定,逐用户 |
| 企业微信 | 接收挂单日报、把处置结果回给销售 | 连接器独立授权 |
| 腾讯文档 | 把当日台账写进共享文档,沉淀到资料库 | 员工本人权限范围内 |
两个容易踩的实现细节
- 网关必须转发 text/event-stream 并保持会话;MCP 的流式响应被缓冲会导致「工具调用看似卡死」。
- 工具描述里写清「什么时候不该用」;否则专员问「今天天气」也会被路由到本体工具。
能力面按版本分层:个人版只有连接器与对话内 widget;企业版另有侧栏自建菜单(iframe,可承载整套前端)、Buddy 应用与默认落地页。讨论企业版时,不应把「只有聊天接口」当作上限。
认证与权限:三档落法,逐人权限是分水岭
本体侧的 MCP 服务没有独立认证体系,走应用的 OAuth 2.0;两种授权模式对应两类场景。 客户端能不能跑授权码流程,决定了你落在哪一档。
| 档位 | 做法 | 保留什么 | 代价与风险 | 适用 |
|---|---|---|---|---|
| A · 服务账号 | client credentials 换 token,静态写进连接器请求头 | 可接入,落地最快 | 所有人共用一个身份:谁放行了哪一单查不出来;token 落在员工机器上;权限取并集,越权面最大 | 只读演示、PoC |
| B · 身份映射 | 网关按当前 WorkBuddy 用户映射到对应本体身份,签发短期 token | 逐人权限与逐人审计基本保留 | 需要维护账号映射表;映射错一个就是越权;映射表本身要纳入变更管理 | 部门级试点 |
| C · 授权码 + 网关 | 网关跑 authorization code,用户在本体侧 consent,token 短期且不下桌面 | 逐人权限、consent 记录、凭证集中托管、集中轮换与吊销 | 多一个组件要运维;需处理回调与刷新 | 生产 |
本 demo 选 C,理由只有一条
「放行」是花钱的动作。审计必须能回答哪个人放的,而不是「某个 token 放的」。 这一条否掉 A,映射表的可维护性否掉 B。
企业版在这里补位
官方版本说明列出的企业能力里,与本 demo 直接相关的是 单点登录、授权管理、智能体配置、成员统计、 企业模型配置——身份源与席位治理在企业侧,数据权限仍留在本体侧。
数据出域这条线
企业版提供共享 VPC / 专享 VPC / 私有化三种交付。选哪一种取决于「本体数据经网关后是否离开受控边界」: 若模型推理在企业外,就要按最严口径评审;信创与数据不出内网的场景走私有化。
空间呈现:同一份口径,画出来的权限
地图不是装饰。它把「仓、在途、目的地」放在同一张图上,而可见范围由同一条行级策略决定。
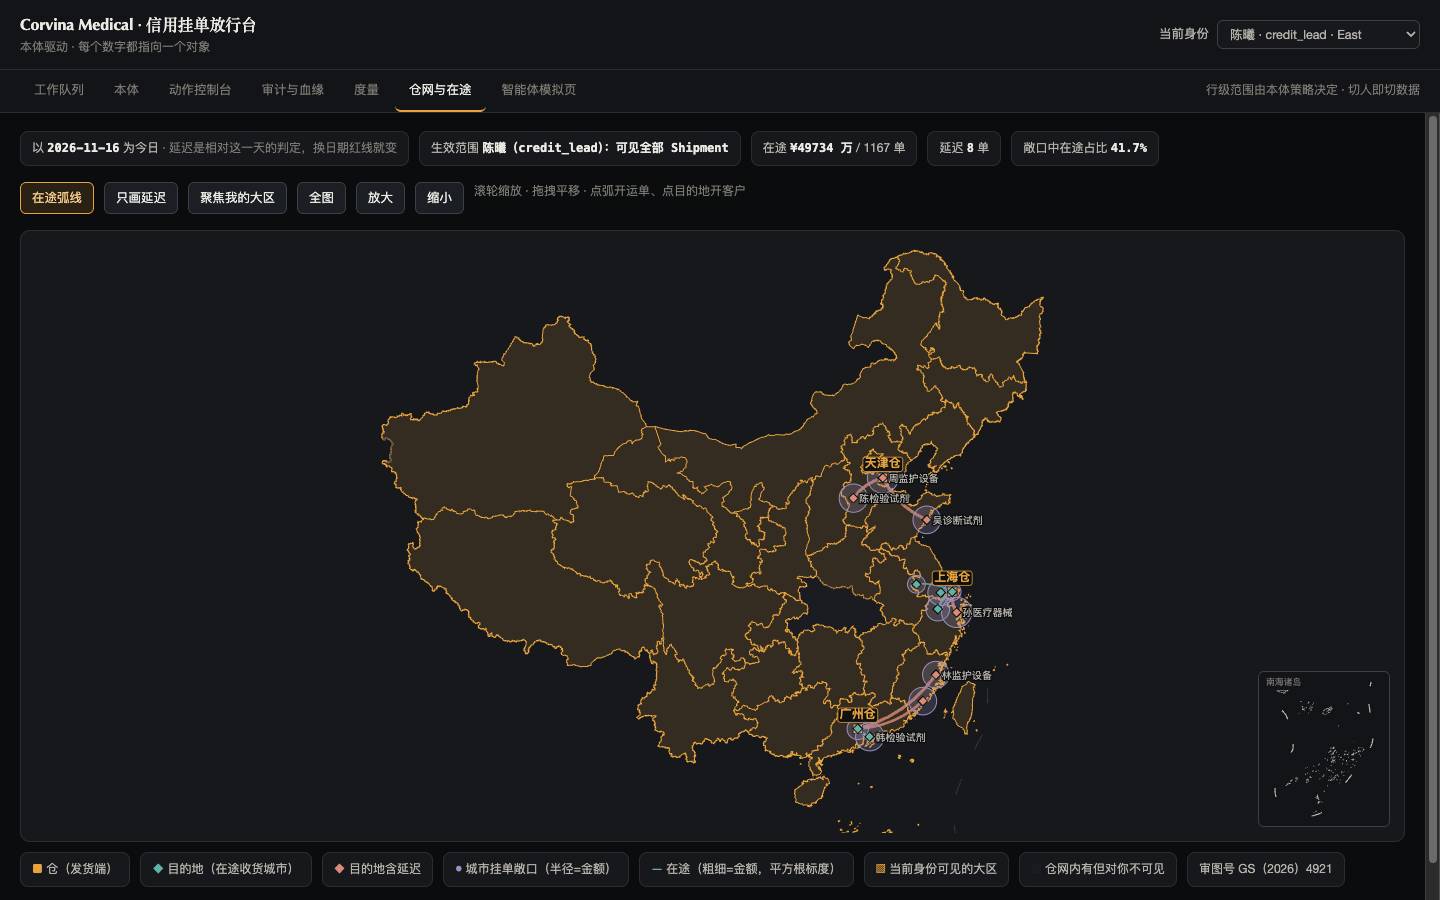
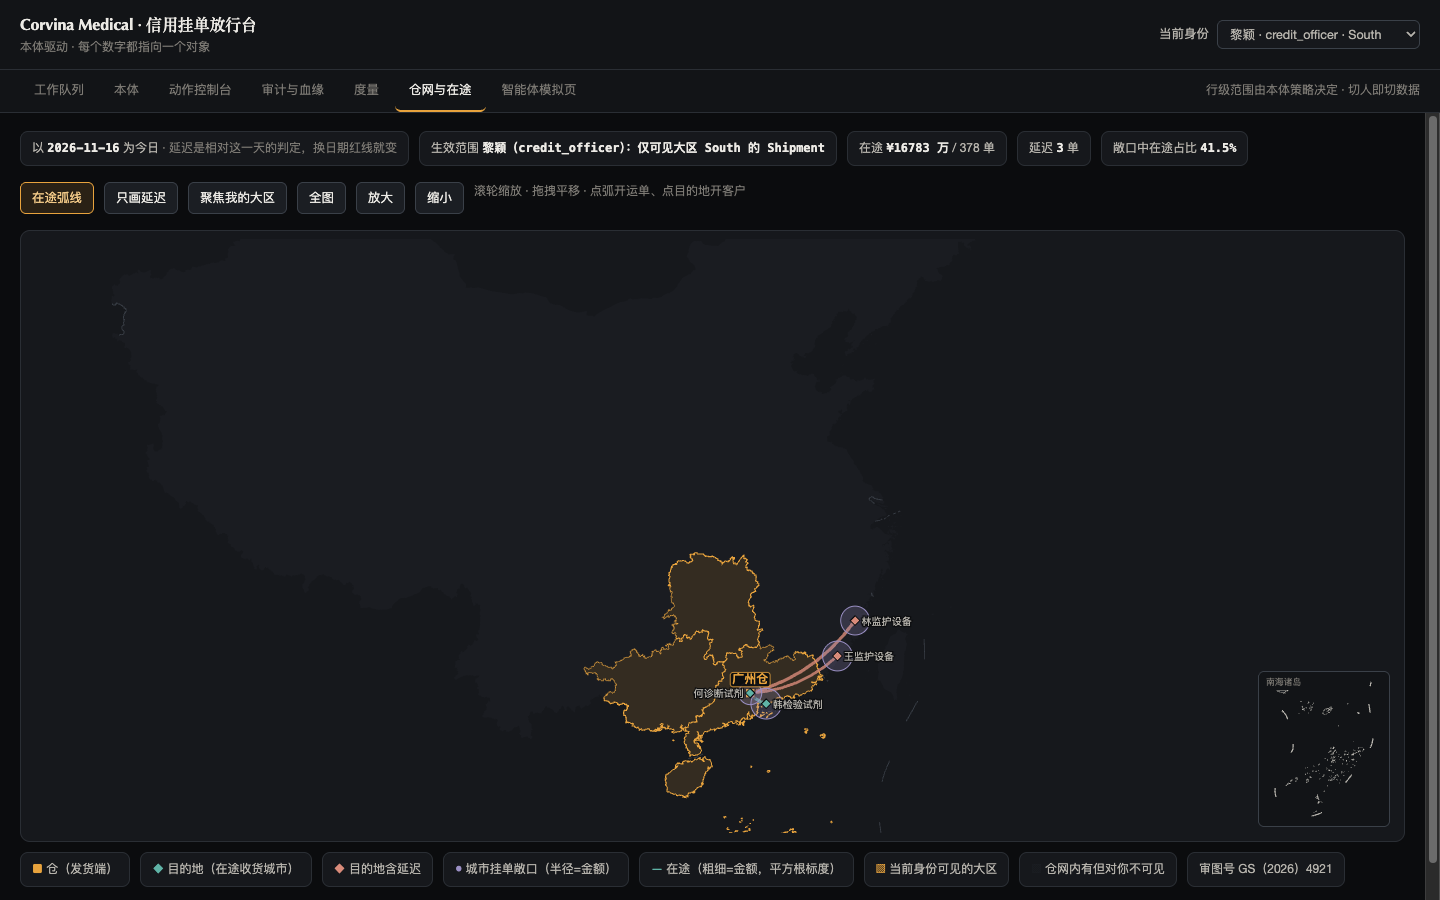
口径同一份
地图、队列与对话读的是同一份对象与同一套函数,不另建汇总表。
权限是画出来的
可见性来自行级策略;换一名专员,整片区域随之改变。
点开是对象
弧线打开一张真运单,目的地打开客户;每个图形都能回溯到对象。
第一幕:读——「今天哪些单该放」
这一幕证明一件事:Agent 拿到的是对象集与实时计算结果,不是文档片段。
专员说
「把金额大于 50 万、还挂着信用的单按风险排个序,只看华东区。」
期望发生的工具调用
- rank_held_orders(min_amount=500000, max_rows=14) → 总匹配 78 条,有界返回前 14 条对象引用(不是把 78 条全塞进上下文)。页宽由调用方给;不传时内核默认 15,所以模型自己调会拿到 15 行
- 对前 3 条 credit_exposure(customer_id) → 实时敞口(含在途)
- 沿链接读 Customer → 历史逾期记录,作为理由依据
界面上看到什么
一张 14 行的工作队列(界面明说「共 78 条,这是第 1 页」),每行带客户名、金额、敞口/额度比、逾期天数、建议处置; 每个数字可点开指向具体对象——引用是对象,不是段落。
| 队列示例 | 敞口/额度 | 逾期 | 建议 |
|---|---|---|---|
| 上海Meridian Care 澜湖医疗 · 一次性耗材 | 118% | 42 天 | 要求预付 30% |
| 苏州Northbay Devices 北汀诊断 · 影像配件 | 96% | 0 天 | 可放行 |
| 宁波Cygnet Bio 西岭检验 · 检验试剂 | 104% | 17 天 | 放行 + 缩短账期 |
下表三行不是手写的样例:把阈值提到 min_amount=900000, 华东专员这一问就恰好返回这三条,建议处置自动分成三种。
这一幕的三个验证点
- 权限:换一名华南专员问同一句话,结果集直接变空(锚点单都在华东), 而去掉金额阈值她的本区队列照常可见——空集是权限正确的证据,不是没数据。
- 新鲜度:ERP 里刚改过额度的客户,敞口比值立刻变化——证明走的是对象而非缓存文档。
- 可追溯:任一数字点开能看到来源对象与属性。
如果这里换成知识库 / GraphRAG
能答出「信用政策规定超过额度需审批」,答不出「今天这 14 单」—— 因为挂单状态在事务系统里,不在文档里。详见 P77 的对照表。
第二幕:写——Agent 暂存,人确认,动作落地
写操作是整章的分水岭:能不能写、怎么写、写错怎么办,全部在这一幕演示完。
| 步骤 | 发生什么 | 观众看到什么 / 失败会怎样 |
|---|---|---|
| 1 提议 | 专员:「Meridian 这单按预付 30% 处理,理由写 Q4 回款已到账」 | Agent 组装参数并复述将要发生的变更,不直接提交 |
| 2 暂存 | 调用 request_prepayment,动作以 staged 状态进入待确认队列 | 本体里出现一条待确认变更;此时 ERP 未收到任何写入 |
| 3 闸门 | 本体侧提交条件重新判定并回显逐条原因。确认那一下由谁给出取决于客户端:个人版 5.9.3 实测不为 MCP 工具调用弹框(权限模式只覆盖文件/脚本/网络),故本 demo 的「人点一下」落在本体控制台,对话侧的确认是自然语言 | 若敞口超阈值或理由为空 → 拒绝并回显具体原因(实测:敞口 118% 直接放行被拒,改预付 30% 压到 82.6% 才过) |
| 4 提交 | 确认后事务提交:改挂单状态、建处置记录、写回 ERP | 任一步失败整个事务回滚,不出现「改了一半」 |
| 5 外部 | 企微通知销售、台账写入腾讯文档、日志留痕 | 外部副作用不可回滚,所以通知里带单号与「以本体为准」声明 |
| 6 撤销 | 发现判断错误 → 人在本体控制台发起反向补偿。撤销不放进 Agent 的工具面:它是改判,权限高于处置(仅原处置人或信用组长可撤),给 Agent 等于让它能推翻别人的决定 | 原动作与撤销动作都在行动日志里,形成完整链。工具面收敛的副作用是好的:实测模型查完工具列表答「我不应该假装去撤销,也不能用重复放行来掩盖」 |
留痕五元组(这一幕的收尾镜头)
(who = 信用专员本人 · when · inputs_snapshot = 敞口 118% / 逾期 42 天 · chosen_option = 预付 30% · outcome_metric = 30 天后回款)
这五元组写进本体之后,下一轮评测集和培训材料就有了真实来源,而不是编造的样例。
信任是拨盘不是开关
上线顺序:全部暂存 + 人审 → 低风险类别(敞口 < 80%)自动提交 → 逐步扩大。 门槛改一次,评测跑一次;不需要改代码。
为什么不在 Agent 里做校验
提交条件必须在动作侧。否则换一个客户端(企微机器人、自研门户)就绕过全部规则。
这一幕最常见的翻车
- 动作无幂等键 → 重复提交两次放行
- Webhook 先于事务 → 通知了未生效的变更
- 确认做成「继续吗?」→ 专员无脑点是
第三幕:从一个人到三个专员——企业版治理
个人验证只是原型;能被管理员复制、被审计、被限流,才叫上线。
① 配一次,全组可用
把本体连接器做成团队可复用的配置:项目级配置一次,成员按角色获得可见与可用范围, 不必每人自己贴 JSON、各自申请 token。
② 把 SOP 封装成 Skill
「8:30 队列 → 逐单判定 → 暂存 → 通知 → 记台账」写成团队技能, 新人不用学提示词;技能版本化,改流程改一处。
③ 定时任务承接日报
8:25 自动跑一次只读队列并推送到企微。定时任务用服务身份, 只允许读;任何写操作必须回到有人确认的会话里。
④ 席位、用量与成本
企业版的成员统计与用量看板承担「谁在用、用多少」; 本体侧的 LLM 容量配额承担「模型调用不挤占交互流量」。两边都要看。
⑤ 身份源统一
单点登录 + 组织架构作为唯一身份源;本体侧的用户与组由同一来源供给, 避免「AI 平台一套人、业务系统一套人」。
⑥ 变更也要评审
连接器、技能、本体资源清单三者的变更绑在一起评审: 多暴露一个对象 = 多一个泄露面,必须有人签字。
| 治理问题 | WorkBuddy 企业版侧 | 本体平台侧 |
|---|---|---|
| 谁能用这个 Agent | 授权管理、席位、角色 | — |
| 谁能看哪些数据 | —(不在此层判断) | 对象与属性安全策略,读时过滤 |
| 谁能做哪些写操作 | 连接器可用范围 | 动作提交条件 + 动作权限 |
| 出事能否定位到人 | 成员统计、会话记录 | 行动日志 + 决策血缘 |
官方支持 vs 需要自建
| 环节 | 状态 | 说明 |
|---|---|---|
| WorkBuddy 接自定义 MCP 连接器 | 官方支持 | 连接器页明确「安装自定义的 MCP 服务」 |
| 连接器独立授权、按需读取、写入需确认 | 官方口径,个人版实测部分不符 | 「写入需确认」在个人版 5.9.3 未见于 MCP 工具调用(模型可一轮内自行暂存并确认);写安全因此不能指望客户端,须落在动作侧两段式 + 提交条件 |
| 企业版 SSO / 授权管理 / 智能体配置 / 成员统计 | 官方支持 | 官方版本说明列出 |
| 专享 VPC / 私有化交付 | 官方支持 | 版本说明中的部署方式 |
| 连接器凭证的集中托管与轮换 | 需自建 | 本 demo 由网关承担 |
| 连接器内的 OAuth(MCP OAuth 2.1) | 官方支持(本机已验证) | 平台发起授权:401 → RFC 9728 发现链 → 动态注册 → PKCE S256 → 一次性 code → 换票,全程由本体自建授权服务器承担 |
| OneID 直接充当连接器的授权服务器 | 不支持 | OneID 的登录回调只接受 http(s),而平台下发的是 workbuddy:// 自定义 scheme;因此由本体自建 AS(联邦到 OneID 尚未实现) |
| 逐人身份(连接器侧 / 页面侧) | 真机实测(2026-11-04 / 05) | 同一天、同一份库:个人版环境变量 170 条(East)vs 企业版授权 193 条(South);页面侧免登后身份来自企业身份平台,内核一行未改 |
| 开放平台 Buddy 应用的发布与分发 | 文档口径(本租户未验证) | 无沙箱或灰度;创建审核 + 配置审核;企业单对同一企业仅一次、授权 ≤ 1 年;下架不释放名称与资源 |
| 连接器 / MCP 的企业级集中管控与审计 | 官方支持(文档已确认,真机待验) | 企业控制台 → AI 资源管理 → 连接器管理:集中创建、按部门/成员设可见范围、启用与策略独立(allow 取交集、deny 取并集且 deny 优先);成员侧无需逐个配置 |
| MCP Apps widget 反向调用工具 | 文档与实测不一致 | 官方文档称「一律弹框授权,拒绝回 {isError:true}」;个人版 5.9.3 实测静默拦截:不弹框、不回应答,服务端 0 次命中。面板必须假定拿不到应答,超时兜底是必需项 |
| 宿主能力声明 | 不能当渲染前提 | 宿主 initialize 未声明 extensions["io.modelcontextprotocol/ui"],却完整实现了 UI 协议并正常渲染。以「能不能读 ui:// 资源」判,别以能力声明判 |
| 本体侧 MCP 服务(对象 / 动作 / 函数暴露) | 平台能力 | Palantir 侧为 beta 起演进;自建平台需自行实现同等契约 |
换成知识库会怎样:六类问题的对照
| 这一幕 | 全文检索 | LLM wiki | GraphRAG | 本体 |
|---|---|---|---|---|
| 「信用政策怎么规定的」 | 可 | 可 | 可 | 可 |
| 「今天哪些单挂着」 | 否 | 否 | 否 | 可 |
| 「这单放行后敞口多少」 | 否 | 否 | 部分(静态图不含在途) | 可 |
| 「直接放行并通知销售」 | 否 | 否 | 否 | 可 |
| 「华南专员看不到华东额度」 | 否 | 否 | 否 | 可 |
| 「三个月后复现当时的判断依据」 | 否 | 否 | 否 | 可 |
口径说明:右表不是说其他体系「做不到」,而是说它们缺少受控写入 + 逐人权限 + 实时状态三者同时成立的前提。 知识体系适合回答「是什么、为什么」,本体适合回答「现在是什么状态、能做什么、谁做的」。
同一链路两次真机复验(2026-11-02 / 11-03)留下两条反面证据: ① 只把三个数字注入对话时,模型把「额度的 18%」算成「敞口的 18%」(21 万 vs 正确 18 万),并自造了 100% 阈值; ② 第二次它每个数字都复述正确,却在收尾把内核字段 suggested_reason_option=q4_collection_received(建议放行时填哪个理由枚举) 讲成「已收 Q4 回款」,并据此建议该单免复核。 第二条比第一条危险:数字全对、语气专业,错的恰好是花钱动作的正当性来源。 结论同 P74 —— 处置依据必须由本体枚举持有、由人确认,不能由模型转述。
可复用配置卡
① 本体资源清单
- 对象:Customer / SalesOrder / CreditHold
- 动作:release_credit_hold · request_prepayment
- 函数:credit_exposure · rank_held_orders
- scope 与 application restrictions 收到最小
- 行级范围由本体策略决定,不写进连接器
② 接入契约
- 传输:HTTP + SSE,网关转发保持流式
- 认证:授权码 + consent,token 短期、不下桌面
- 身份:网关做用户映射,映射表纳入变更管理
- 写动作两段式(confirm + stage_id)由工具自身实现;MCP 侧可声明的只有 idempotentHint / destructiveHint,确认弹框由客户端策略决定
- 审计:网关访问日志 ↔ 本体行动日志双向可查
③ 客户端配置
- 项目级连接器,管理员配一次
- SOP 封装为团队技能,版本化
- 定时任务只读;写操作回到有人确认的会话
- 身份源统一:SSO + 组织架构
- 用量看板与模型容量配额两边同时监控
- 模型账:前端页面零模型调用;推理只发生在会话/任务中并计入平台 Credits;自配模型不进入平台账
| 验收项 | 通过标准 | 不通过说明什么 |
|---|---|---|
| 工具发现 | Inspector 里恰好 7 个工具,Prompts 为空,Resources 只含那一个 ui:// 界面资源 | 资源清单泄漏或范围过大(业务数据一旦能从资源口读到,行级过滤便失去意义) |
| 逐人权限 | 两个不同区域专员提问,结果集不同 | 身份映射未生效,退化成服务账号 |
| 新鲜度 | 源系统改额度后,敞口比值在承诺时间内变化 | 索引延迟未测,AI 在用旧数据 |
| 写安全 | 不确认不提交;重复提交不重复生效 | 缺确认闸门或缺幂等键 |
| 可追溯 | 任一条建议能指回对象与当时的输入快照 | 决策血缘没建,学习闭环不存在 |
| 回滚演练 | 做一次撤销,原动作与撤销动作都在日志中 | 业务方不会敢把真实流程交给你 |
一页总结:本体 = 决策的可计算化
带走这五句
- 建模单位是决策,不是表;数据 / 逻辑 / 动作 / 权限必须一起建。
- 身份(主键、标题键、API name)是地基,改它等于重建平台。
- 写入必须有唯一入口,否则审计与权限同时失效。
- Logic 判、Action 落;给 AI 的是一组窄参数工具,而不是一套通用接口。
- 把决策本身建成数据(血缘 + 结果),学习闭环才存在。
三个最容易翻车的点
- 索引延迟与新鲜度没测 → 业务不信任数据
- 权限事后补 → 敏感列已扩散,收不回来
- 没有评测就上线 AI → 非确定性变成事故
事实边界:本稿全部内容来自 Palantir 公开文档与官方博客,案例公司 Onyx 与 Titan 为官方虚构,第Ⅶ章的 Corvina Medical 及其客户为本次教学新编,数字均不可作为真实业绩引用; 涉及自建平台的归纳(六层沙箱、六面架构、路线图)是本稿的结构化整理,不是 Palantir 术语。
版权:Palantir、Foundry、AIP、Onyx、Titan 等名称、界面截图与官方视频归 Palantir Technologies 及其关联公司所有;WorkBuddy 及其他商号、商标、界面等归其各自权利人。上述内容仅作教学引用,不代表权利人认可本稿观点。本稿文字、图表与 Corvina Medical 教学案例归瀚好智慧科技所有。
时效:引用资料检索截止 2026-11-06。产品功能、命名、权限与计费口径此后可能调整,以官方最新文档与合同为准;文中「本机已验证 / 真机实测」仅代表本次环境与版本。
使用:文中架构、配置、代码与验收项均为教学示例,仅供参考,不构成 Palantir、WorkBuddy 或其代理商的官方承诺、实施建议或合规意见;演示数据、客户与数字均为虚构,不代表真实业务结果,据此开发、采购或商务决策的风险由实施方自行承担。
© 瀚好智慧科技 · hanhao.co